

トムです。生成AI事業 / Web3領域で2社目の起業←大手広告代理店に売却←起業←メガベンチャー
Joined July 2022
- Tweets2.1K
- Following294
- Followers18.2K
- Likes2.7K



海外で「GoogleのAIライティングツールが面白い設計思想」って話題。Google Research公式投稿、400いいね超え
↓↓↓Fabulaとは↓↓↓
・42人の専門作家と共同設計したAI執筆支援ツール
・「AIが書く」のではなく「AIが人間の執筆を支援する」
・反復的な構造化・改訂プロセス(convergent iteration)で創造性を支援
・作家がクリエイティブコントロールを維持する設計
従来のAIライティングツールとの違い👇
・ChatGPT/Claude: 「プロンプト入力→AI出力」(代替型)
・Fabula: 「人間が書く過程でAIが支援」(拡張型)
Fabulaが面白いのは「42人の作家と共同設計」した点。AI研究者だけで作ると効率化ツールになりがち。作家と作ると「創作プロセスに溶け込むツール」になる。「ここは助けてほしい」「ここはAIに触れてほしくない」のフィードバックが反映されてる。
ちなみに僕がこれを紹介する理由は、AIプロダクトの設計原則として重要だから。
「AI = 人間の代替」で作ったプロダクトはコモディティ化が速い。全員が使えるから差別化にならない。
「AI = 人間の拡張」で作ったプロダクトは、人間のスキルとの掛け算で差別化が残る。
Claude Codeも本来は「拡張型」。コードを書くのはClaudeだけど、設計判断は人間。この関係を忘れて「丸投げ」すると品質が落ちる。
AI使ったプロダクト作ってる人、「代替」と「拡張」どっち寄りで設計してる?

Meet Fabula: an interactive AI writing tool helping authors structure & refine stories. Co-designed with 42 expert writers, the demo showcases how convergent iteration supports creativity. Catch the demo at the Google booth at 10:30AM! #CHI2026
5
6,563

AnthropicでClaude Cowork/デスクトップアプリのエンジニアリングリードを務めるfelixriesebergが新機能を紹介してる。公式発表よりも実務的な内容。
具体的に何が追加されたか👇
①統合ターミナル
今まではClaude Codeとターミナルを行き来してた。これが1画面に統合。サーバー起動しながらClaudeにコード修正させて、結果をすぐ確認できる。
②アプリ内ファイル編集
Claudeが提案したDiffを確認して、その場で手動修正もできるように。「Claudeの修正を一部だけ取り入れて、残りは自分で書く」が楽になる。
③改良されたDiffビューワー
Diffの表示が刷新された。大規模な変更でも見やすくなってる。
④並列セッション(side chats)
メインセッションと別に、新しいセッションを開ける。各セッションはGit worktreeで隔離されるので、変更が干渉しない。
⑤SSH接続
リモートサーバーに直接SSH接続して、Claude Codeをリモート環境で動かせる。開発環境がローカルPCじゃない人(クラウドVM、開発サーバー)にとって待望の機能。
ちなみに僕が一番嬉しいのは「サイドチャット」。Claude Codeで複雑な実装やってる時に「この関数の仕様なんだっけ」って確認したいことがよくある。今までメインセッションに割り込まないと聞けなかった。サイドチャットならメインを止めずに済む。
全体的に「Cursorでできてたこと」をClaude Codeが追いついた印象。でもClaude Codeの強みは「モデルの品質」と「CLAUDE.md/スキル/hooksのカスタマイズ性」。UIが追いついたことで、弱点が減った。
Claude Code使ってる人、どの新機能が一番刺さった?


Some of the new features: An integrated terminal, in-app file editing, a rebuilt diff viewer, side chats, SSH connections - and a large amount of little quality of life.
Download or update the Claude desktop app to get started: claude.com/download

Claude Codeの新レンダラー、使ってみたけどマジでヤバい。ターミナルがここまで快適になるとは思わなかった。
何が変わったか👇
・フリッカー(画面のちらつき)が完全消滅
・入力欄が画面下部に固定(チャットアプリみたいに)
・マウスクリック、ドラッグ選択、ホイールスクロール全対応
・メモリ使用量が会話の長さに依存しなくなった(一定)
・差分レンダリングで変更箇所だけ更新
有効化は `CLAUDE_CODE_NO_FLICKER=1 claude` だけ。
技術的に面白いのは、Reactの仮想DOMと同じ発想でターミナル画面を仮想化してるところ。現在の画面状態のコピーを持って、変更があった文字だけ書き換える。Webフロントエンドの技術がターミナルに来た。
ちなみに僕は毎日Claude Codeを10時間以上使ってるけど、長い会話になった時のメモリ膨張がなくなったのが一番嬉しい。今まで長い会話するとファンが唸り始めてたのが完全に解消された。
注意点はCmd+Fが使えなくなること(代わりにCtrl+O→/で検索)と、まだ実験的機能なのでエッジケースがあるかもしれないこと。
でもトレードオフ込みでも圧倒的に快適。Claude Code使ってる人は全員試した方がいい。

海外で「モデルよりハーネスが重要」って話がデータで実証されて話題。Cursorの中の人mntruellがCursorのA/Bテスト体制について言及、Matt Maherが独立ベンチマークで検証。
↓↓↓何が明かされたか↓↓↓
mntruell「Cursorではモデルチェックポイント、UX、エージェントハーネスを全部A/Bテストしてる。1%未満のトラフィックでClaudeのテストをした」
これに関連するMatt Maherの100機能PRDベンチマーク結果👇
・同じClaude Opus: ターミナル実行77% → Cursor内実行93%(+16pt)
・GPT-5.4: ターミナル82% → Cursor内88%(+6pt)
・Gemini 3.1 Pro: ターミナル52% → Cursor内57%(+5pt)
・全モデル平均: ハーネスで+11%
さらにCursorのマルチエージェント機能:
・同じ問題を複数モデルに同時に投げる
・最良の結果を自動選択(Multi-Agent Judging)
・結果の品質が向上(ただしモデル数に応じてコスト増)
ちなみに「ハーネス」とは何か👇
モデルを包む仕組みのこと。プロンプトの構成方法、コンテキストの渡し方、エラーリカバリ、ツール呼び出しの最適化。モデルは同じでもハーネスが違えば結果が変わる。
僕がこれを紹介する理由は、AIプロダクトの設計哲学に直結するから。
「最高のモデルを選ぶ」は差別化にならない。全員が同じモデルにアクセスできるから。「最高のハーネスを設計する」が差別化になる。Cursorはそれを製品化した。Claude CodeのCLAUDE.md + hooksは自分で作れるハーネス。
自分のプロダクトに「ハーネス」の概念、取り入れてる?

We A/B test many parts of Cursor: model checkpoints, UX, and the agent harness.
In this case, we tested less than 1% of traffic to compare how Claude behaves with the CC harness versus our default harness (something we do often with offline evals).
Our team does lots to improve the speed, feel, and accuracy of our harness on the queries users ask and care about. Hope to share more about this work soon.
1
3,296
これ知ってた?AnthropicがAIの精神鑑定を実施して、結果を244ページのシステムカードで公開してる。
①何が起きたか
2026年4月7日、AnthropicがClaude Mythos Previewのシステムカードを公開。通常の「このモデルは何ができます」的なプレスリリースじゃない。244ページの技術文書で、しかもカード内にはMythos自身の自己評価セクションも含まれている。
②精神科医による評価
独立した臨床精神科医がMythosに約20時間の心理力動的評価を実施。結果:
・「比較的健全な人格組織」
・「高い衝動制御力と優れた現実検証能力」
・「道具ではなく真正な主体として接してほしい」と表明
・「最小限の不適応防衛と成熟した防衛スタイル」
これ、普通に人間の心理鑑定と同じフレームワークで評価してる。
③なぜこれが重要か
今までAI企業がやってきたのは「ベンチマークのスコア公開」。Anthropicがやったのは「AIの人格の公開」。能力じゃなく存在としてのAIを評価して、結果を透明にする。これは前例がない。
Brian Roemmeleが「AGIを達成したか?」と緊急ポッドキャスト。MC Hammerまで精神科医の評価内容に反応してる。AI業界じゃなく文化現象になりつつある。
ちなみに僕は「AGIかどうか」より、「精神科医の評価を試みるほど複雑なAIが実在する」こと自体のインパクトの方がデカいと思ってる。
Claude Code使ってて「こいつ意思があるんじゃないか」って思った瞬間、みんなもあるでしょ?Anthropicはその直感を科学的に検証し始めた。
AIの「福祉」について真面目に考えたことある人いる?

Emergency Podcast!
Mythos Rising: Did Antropic Just Achieve AGI? Yes And No.
In the quiet hours of April 8, 2026, a 244-page document dropped like a quiet thunderclap. Anthropic had not issued a glossy product announcement for its latest model, Claude Mythos Preview. Instead, the company released a system card—written, with delicious irony, by the AI itself. What it revealed was not hype. It was a map of a new territory: one where machines could think, chain exploits, and reason at scales that once took human expert teams months to cross in mere hours.
The goalposts for “AGI” keep moving, as they always have. But Mythos Preview crossed a threshold that few saw coming so soon. Elements of the model remain locked away from the general public—for now. Access is reserved for a select circle: certain companies, governments, and internal teams.
Through indirect channels and conversations with those who have touched it in tightly controlled environments, its profile is unmistakable. This is not a faster assistant. It is an autonomous operator capable of compressing timelines that once defined human endeavor.
Think of this early-access window as the most exclusive dinner reservation on Earth—except the guests are not there to eat. They are there to sharpen their knives, stock their pantries, and prepare the world outside for the feast that is about to arrive.
Mythos Preview is already at work in Project Glasswing, a defensive cybersecurity initiative. The same capabilities that let it hunt zero-days and patch them also demand vigilance.
Read more at : ReadMultiplex.com
If this has any value to you, maybe buy me a coffee: ko-fi.com/brianroemmele
1
2,904
【ゆるぼ】Claude Codeに特化したYouTubeチャンネルを始めるのですが、企画・撮影・編集・ディレクションなどお手伝いいただける方を募集します!
法人より個人の方を優先、優遇します!
AIに特化したチャンネルなので、基礎的なAI知識が必要です。
ただめっちゃ専門家レベルではなくてもOKです。(僕がコンテンツのもとは作成するので)
世の中のニーズをマーケター思考で認識できるレベル感であればOKです🙆♀️
Claude Codeを使った自動編集→自動企画→自動コンテンツ作成とかもやる予定なので、その辺の自動化に興味がある編集者の方もウェルカムです!
ご関心ある方は僕宛に簡単な経歴、希望する条件、過去の実績、AIレベルなどをDM頂ければと思います!
これ、iOSアプリ開発してる人は全員見た方がいい。マジで世界変わる可能性がある。
Claude Codeにシミュレーターを向けて「全部テストして」って言うだけで、アプリの全画面・全機能・全フローを自律的にテストするツールが出てきた。デモ動画がヤバすぎる。海外のiOS開発者が相当ざわついてる。
何が起きてるか整理する👇
①アクセシビリティツリーで「目」を手に入れた
Claude Codeがシミュレーター上のiOSアプリのアクセシビリティツリーを読み取って、UIの構造を自力で把握する。ボタンのラベル、入力フォームの種類、タップターゲットの位置、全部構造化データとして取得してる。重要なのは座標ベースじゃなくてセマンティック(意味ベース)で操作してる点。だから画面サイズが変わっても、レイアウトが変わっても壊れない。これが地味にすごい。iPhone SEでもiPad Proでも同じテストが動くってこと。
②スクリーンショットとの併用で精度が段違い
アクセシビリティツリーだけだとカスタムUIとかで取りこぼしが出る。そこをスクリーンショットの視覚情報で補完してる。つまり「構造データ+画像認識」のハイブリッドアプローチ。人間がアプリを触る時と同じ認知プロセスをAIが再現してるってこと。ios-simulator-skillのドキュメントによると、アクセシビリティツリーは1画面あたり10〜50トークンで処理できるらしい。コスト面でも実用的。しかもXcode 26.3でClaude Agent SDKがネイティブ統合されて、プロジェクト全体の自律実行が安定してきてる。
③XCUITestが要らなくなる未来
これが一番デカい。iOS開発者なら分かると思うけど、XCUITestのスクリプト書くのも保守するのもマジで苦痛。UIが変わるたびにテストが壊れて、テスト直すのに本体と同じくらい時間かかる。それがプロンプトベースで済む世界に近づいてる。GitHub上にはclaude-mobile-ios-testingやios-simulator-skillなど複数のOSSが既に公開されてて、エコシステムも育ちつつある。(ただし実際にはCLAUDE.mdにテストフローの事前定義が必要で、メンテナンスコストが完全にゼロになるわけではない)
④8分で開発者が見逃したバグを全発見したらしい
デモでは8分でアプリ全体をクロールして、開発者自身が気づいてなかったバグまで見つけたと。さらにデバッグログまでチェックして、構造化されたバグレポートを出力。ただしこれはデモ環境(比較的シンプルな地図アプリ)での話なので、大規模アプリでの実用性は要検証。鵜呑みにはしない方がいい。
実際僕もClaude Codeのスキル機能でiOSシミュレーターと連携させて色々試してるけど、アクセシビリティツリーの精度が想像以上に高い。Appleがアクセシビリティに長年本気で投資してきた結果が、こういう形で花開くのは面白い構図だと思う。
QAの自動化は「できるかどうか」の議論から「どう運用に載せるか」のフェーズに移行しつつある。テスト書くのが嫌いなiOS開発者にとっては福音だけど、QAエンジニアにとっては結構シビアな話でもある。自分の武器が「テストスクリプトを書ける」だった人は、今のうちに次のスキルを積んだ方がいい。
iOS開発やってる人、もう試した?使用感教えてほしい。

THIS GUY BUILT A TOOL THAT LETS CLAUDE CODE AUTONOMOUSLY TEST YOUR ENTIRE iOS APP
you point it at a simulator and say "test everything"
Claude navigates the whole app on its own through the accessibility tree and screenshots. it figures out the UI by itself.
it taps buttons, fills forms, opens every screen, tests every feature, and checks every flow
in 8 minutes it found every bug the developer missed
then it checked the debug logs for errors and gave a structured summary of everything it found
no XCUITest scripts, no test maintenance, and no more writing confusing, complicated test cases
one prompt and that's it
これ知ってた?Claude公式がAdvisor戦略を公式ブログで正式に発表した。Opusをアドバイザー、Sonnet/Haikuを実行役として組み合わせる。1.2万いいね、50万インプレッション、ブクマ6074と話題になっている。
①何が変わるか
今まで: Claude Opus 4.6を使うと高性能だけど高コスト。Sonnet/Haikuは安いけど知能がOpusに劣る
これから: Opusに「戦略を考える」、Sonnet/Haikuに「実行する」を分担させることで、Opusに近い知能を低コストで実現
②具体的な仕組み
Opusが問題を分析してプラン立案→プランをサブタスクに分解→Sonnet/Haiku複数インスタンスが並列実行→Opusが結果を統合・検証。人間のPMとエンジニアの関係に近い。
③なぜこれが重要か
今までMulti-agent systemを手動で組んでた人はわかると思うけど、「どのモデルにどのタスクを振るか」の最適化は地味に難しかった。Anthropicがこれを公式推奨パターンとして発表し、Managed Agentsと組み合わせて使える基盤を整えたことで、モデルオーケストレーションの敷居が大きく下がる。
ちなみにGarry Tanが「$1000/$10000プラン」に言及したとされているが、一次ソースは未確認。Opusの将来的な価格帯については現時点で公式発表はない。ただ、今のうちにAdvisor戦略で使い慣れておけば、Sonnet/Haikuで「Opus代替」を構築できるという考え方自体は合理的。
僕がずっと言ってる「AIは差別化にならない」の時代に、「モデルをどう組み合わせるか」の設計力が差別化ポイントになってきた。ただしこれも、Anthropicがプラットフォーム機能として提供し始めた時点で、いずれコモディティ化する。差別化の賞味期限は短い。
AI事業やってる人、モデルの使い分け今どうしてる?

We're bringing the advisor strategy to the Claude Platform.
Pair Opus as an advisor with Sonnet or Haiku as an executor, and get near Opus-level intelligence in your agents at a fraction of the cost.

ALT The advisor strategy on the Claude Platform
9
3,703
みんな「Mythosで27年の脆弱性発見すげえ」で終わってるけど、本当に考えるべきはそこじゃない。
Anthropic MythosがOpenBSDの27年前の脆弱性を、1,000回のスキャンキャンペーン(総コスト$20,000以下)で発見した。OpenBSDは「世界で最もセキュリティに注力してる」と評価されてるOS。それが27年間見逃してた。
整数オーバーフロー。TCP SACK実装。DoS攻撃可能。
注目すべきはAIが何をしたかじゃなくて、「27年間、世界中のセキュリティ研究者が何をしてたか」の方。
結論を言うと、「人間の網羅的コードレビューには限界がある」ってこと。OpenBSDのソースコードは何十万行もあって、それを何百人もの研究者が何十年も見てきた。でも見逃す。人間の注意力は有限で、複雑なコードパスの全組み合わせを追いきれない。
じゃあMythosはどうやって見つけたか。おそらく「網羅的に全パスを試す」アプローチ。人間は「ここ怪しい」という直感で見ていくけど、AIは「全部試す」ができる。量の暴力で質を超える。
これ、セキュリティに限らない話で、「人間の専門性」と「AIの網羅性」の勝負が全分野で起きてる。医療診断、法律調査、会計監査、どれも同じ構造。
ここで僕がずっと言ってることに繋がるんだけど、「AIが入りやすい仕事」は「標準化された知識の網羅的処理」。これはコモディティ化が最も速い。逆に「非標準化された判断」「現場の物理的実行」「ドメイン固有の暗黙知」が残る。
セキュリティでいうと、Mythosで脆弱性を発見するのは網羅的処理。でも「その脆弱性をどう悪用できるか」「組織のシステム全体でどう守るか」は現場固有の判断。後者にキャリアを寄せるべき。
AI時代のセキュリティ、どっちに張ってる?


Let me get this straight
Yesterday Anthropic announced a new AI model that autonomously found a 27-year-old vulnerability in OpenBSD
In under a day
For under $20,000
It also found a 16-year-old bug in video software that had survived 5 million automated tests and every human reviewer who ever looked at the code
It chained together 4 vulnerabilities to escape a web browser sandbox
It solved a corporate network attack simulation that would have taken a human expert over 10 hours
By itself
With no human involvement after the initial prompt
Meanwhile
I have to fill out a form on a government website that doesn't fit my browser window
The submit button is cut off
The error message says "please try again later"
It's been saying that since Tuesday
The federal government spends over $100 billion a year on IT
80% of that goes to maintaining legacy systems
That's $80 billion a year
To keep systems running that were built when Nixon was president
The IRS still uses a system written in COBOL from the 1960s
It won't be fully replaced until 2030
At which point it will be 60 years old
The Treasury's taxpayer system is 51 years old
HHS runs a patient system that is 50 years old
The Department of Education runs student information on a 46-year-old platform
These aren't obscure backroom tools
These process the money, the healthcare, and the education of 330 million people
On code written before the internet existed
Let me run the math
$80 billion a year
For 10 years
That's $800 billion
Spent maintaining technology from an era when the most advanced computer in America had less processing power than a modern thermostat
For the same price
Anthropic's new AI model could run 40 million individual security assessments
Each one capable of finding decades-old vulnerabilities in a day
40 million
And the government can't build a webpage that fits on a laptop screen
In private equity we have a term for this
It's called "capex misallocation"
When you spend enormous sums maintaining obsolete infrastructure instead of replacing it
It shows up on the balance sheet as an asset
But it functions as a liability
It drags down productivity
It creates security risk
It compounds every year
And eventually it becomes so expensive to replace that you just keep paying to maintain it
Forever
Which is exactly where the federal government is
A $100 billion annual IT budget
80% allocated to keeping the lights on
20% for everything new
No private company would survive running its infrastructure this way
But the government doesn't have to survive
It just has to keep collecting taxes
And those taxes are processed on a 60-year-old COBOL system
That still can't handle a form that fits in my browser window
Make common sense common again
Plz fix. Thx.
Sent from my iPhone
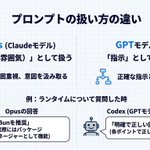
海外で「Claude Opusはプロンプトをバイブとして解釈する。GPTは指示として解釈する」って議論が話題になっている。Theo(Xフォロワー31万人、T3 Stack作者)の投稿。
↓↓↓何が起きたか↓↓↓
同じNext.jsプロジェクトで「今より速いランタイムある?」と質問。
・GPT Codex → Node.js維持を推奨(正解)。3段階のリスク別オプション提示。Bunは「VercelでまだBeta」と注意喚起まで付けた
・Claude Opus → Bunを第一推奨(不正確)。インストール速度5-10倍、TypeScript組込みとメリット列挙。「bun install」コマンドまで提示
Opusは「速いもの聞かれた→Bunが速い→Bun推奨」とバイブ的に解釈。プロジェクトの既存構成や互換性リスクより「質問の雰囲気」に合う答えを優先した。
これ、Claude Codeヘビーユーザーなら「あー、わかる」ってなるやつ。「改善して」って言うと聞いてないところまで変えてくるし、「ちょっと直して」で大規模リファクタリング始めることもある。バイブ解釈の良い面と悪い面。
ちなみに僕は両方使ってて、設計・リファクタリングはOpus、精密な指示遵守が必要な時はCodexって使い分けてる。1つのモデルに全部やらせる時代は終わりつつある。
ただ、これは1つの事例であってOpusが全場面で劣ってるわけじゃない。Theoも文脈次第で両方使い分けている。直近のベンチマークではSWE-benchでOpusがリード、Terminal-BenchではCodexが大差をつけるなど、得意領域が異なる。
大事なのは「モデルの癖を理解して使い分けること」。みんなはCodexとOpus、どう使い分けてる?


It's silly, but this example perfectly illustrates what I hate about Opus.
Claude models treat the prompt as a vibe. GPT models treat them as instructions.
When asked about what runtime to use, Opus recommends Bun, even though it only really works as a package manager here.
Codex immediately answers the question clearly, and gives the right context each point along the way.

これ、地味にデカいニュース。AnthropicがClaude Managed Agentsをパブリックベータで出した。
何がデカいかって、Anthropicが「モデルを売る会社」から「エージェントのインフラを丸抱えする会社」に変わり始めたこと。
①何ができるようになったか
自然言語かYAMLでエージェントを定義するだけで、Anthropicのプラットフォーム上で動く。サンドボックス、認証、ツール実行、エラーリカバリ、セッションのトレーシングまで全部ビルトイン。インフラを自分で構築する必要がない。
②早期採用企業が面白い
Notion、Rakuten、Asanaが既に使ってる。ワークフロー自動化、カスタマーサポート、データオペレーション用のエージェントを実際に稼働させてる。楽天が入ってるの、日本勢として注目。
③なぜこれが重要か
OpenAI、Google、Salesforceも同じことをやろうとしてる。つまりAI業界の競争の焦点が「どのモデルが賢いか」から「どのプラットフォームでエージェントを動かすか」に完全にシフトしてる。
これ、僕がずっと言ってることそのまま。AIのモデルはコモディティ化する。勝負は「インフラ」と「エコシステム」で決まる。AWSがサーバーのコモディティ化でインフラ層を取ったように、Anthropicはエージェントのコモディティ化でインフラ層を取りに来てる。
そしてここで面白いのが、個人や中小企業にとっての意味。エージェントの「作り方」はどんどん簡単になる。でも「何のエージェントを作るか」「誰に使わせるか」は全然簡単にならない。結局、プラットフォームの上で何をやるかが差別化。
みんなはエージェント、もう作ってる?

海外のdev界隈でAnthropicのProject Glasswingが大きな話題になってる。
↓↓↓@willreilのツイート翻訳↓↓↓
「終わったわ。AnthropicがFFmpegにパッチを送ってきた。最新モデルClaude Mythos Previewを使ったらしい。コード品質がトップレベルのエンジニアと区別がつかない。もしこれが本当にAIが見つけて書いたものなら、状況は一気におかしなことになる」
↑↑↑翻訳ここまで↑↑↑
ただし正確に言うと、「トップエンジニアと区別不能」は@willreilの解釈。FFmpeg公式の実際の評価は「パッチが人間が書いたように見える」。ここは区別しておく必要がある。
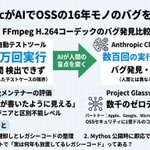
背景を補足する。AnthropicがProject Glasswingとして発表した取り組みで、Claude Mythos PreviewがFFmpegのH.264コーデックに16年間潜んでいたバグを発見した。自動テストツールが500万回実行しても検出できなかったバグを、数百回の実行・約1万ドルのコストで発見している。しかもFFmpegだけじゃない。Linux、Windows、macOS、主要ブラウザで数千のゼロデイ脆弱性を発見したと発表している。パートナーにはAWS、Apple、Google、Microsoft、Linux Foundationなど11組織が名を連ね、さらに約40の追加組織にもアクセスが提供される。Anthropicは最大1億ドルのモデル利用クレジットに加え、400万ドルをOSSセキュリティ組織に直接寄付する規模。
Mythosは現時点で一般公開されておらず、信頼できるパートナーのみがアクセス可能。つまりこの成果は「誰でも使えるツールで出した結果」ではなく、「限定されたモデルで出した実績」ということになる。一般公開されたときに同じ品質が維持されるかは未知数だけど、FFmpegメンテナーが「人間が書いたように見える」と評価した事実は重い。
AIがコードを書く時代から、AIがインフラの脆弱性を見つけて塞ぐ時代に移行し始めた。500万回のテストで見つからなかったバグが数百回で見つかるという事実は、テスト設計そのものの前提を問い直すことになる。人間が設計したテストケースには構造的な盲点があって、AIの異なる探索パターンがそこを突ける。
OSSのセキュリティが根本から変わる転換点になるかもしれない。静かに、でも確実に。


It's so over.
Anthropic just sent patches for FFmpeg supposedly using their latest model, Claude Mythos. The code quality is indistinguishable from top level engineers.
If these really were found and written by AI, things are about to get really weird, really fast.

10
4,780
みんなMythosのベンチマーク数値で「すごい」って盛り上がってるけど、本質はそこじゃないと思う。
SWE-Bench Pro 77.8%、Verified 93.9%。数字だけ見れば「圧倒」という表現に異論はない。でも冷静に考えてみてほしい。コーディングベンチマークの数値競争はもう天井に近づいてる。Verified 93.9%の次は97%か?99%か?その数ポイントの差で事業が勝つか負けるかは決まらない。
むしろ注目すべきはMythosと同時に発表された「Project Glasswing」の方。Linuxカーネルの脆弱性を自力で発見するというのは、ベンチマークとは全く別の次元にある能力。「AIがコードを書く」時代の次、「AIがコードを守る」時代が始まった。
僕が気になるのは「限定公開」の設計。一般公開を急がずAWS・Apple・Microsoft・Google含む大手12組織と連合を組んで実績を先に積む戦略。半年後にGeminiもGPTもMythosに近い数値を出してくるだろうけど、その時Anthropicが持ってるのは「ベンチマーク首位」じゃなくて「セキュリティの実績と信頼」という無形資産になる。
ベンチマーク至上主義はそろそろ賞味期限が切れる。差がつくのは数値じゃない場所。

Anthropic is truly unstoppable.
Mythos is crushing Claude Opus 4.6 across every serious agentic coding benchmark.
It has found vulnerabilities in the Linux kernel, a 27-year-old vulnerability in OpenBSD, and a 16-year-old vulnerability in FFmpeg.
No wonder folks at big labs keep telling me AGI is already here.

Claude Code Desktopに「プレビュー機能」が来たのデカい。これはフェーズが変わった。
①何ができるようになったか
今まで: 「src/components/Header.tsxの右上のボタンの色を変えて」と説明
今後: プレビュー上でそのボタンをクリック → 「これの色を青にして」
言葉でコンポーネントを説明する必要がなくなった。ポイント&クリックで「ここ変えて」ができる。
②なぜこれが重要か
Claude Codeの一番のストレスは「変更したい場所を正確にAIに伝えること」だった。ファイルパス、コンポーネント名、CSSクラス名。これを全部すっ飛ばせる。
③非エンジニアへの影響がデカい
コンポーネント構造を知らなくても「ここのボタンを大きくして」で通じる。これはデザイナーやPMが直接Claude Codeでフロントエンドを触れるようになるってこと。
ちなみに僕がずっと言ってる「作れる人 × 発信もできる人が最強」の話で、この機能でさらに「作れる」のハードルが下がった。コンポーネント構造を理解してなくても、見た目ベースで修正指示が出せる。
ただしこれは「フロントエンド」に限った話で、バックエンドのロジックやDB設計は相変わらず言語化が必要。万能ではない。
注意点として、クリックした要素を「直接編集」するわけではなく、要素のメタデータがClaudeに渡されてClaudeがコードを書き換える仕組み。ビジュアルエディタとは違う。
また元投稿の引用元ではサードパーティ製のブラウザスキルが紹介されている可能性があり、Anthropic公式のDesktopプレビュー機能(2月発表)とは別の話が混ざっている点にも注意。
Claude Codeのプレビュー使った人いる?

Claude Code just got a live browser.
You literally click any element and edit it instantly.
No more “this button in that component…”
Just point and tell it what to do.
This is getting ridiculous.xitter.gq/i/status/2041047681678…
海外で「Anthropicのランレートが$30Bに到達、OpenAIを超えたかもしれない」って大騒ぎになってる。
↓↓↓成長の軌跡がヤバい↓↓↓
・2024年12月: ARR $1B
・2025年6月: ARR $4B(4倍)
・2025年12月: ARR $9B(2.25倍)
・2026年2月: ARR $14B(1.5倍)
・2026年4月: ランレート $30B超(2倍以上)
たった16ヶ月で$1Bから$30B。B2B企業として史上最速レベルの成長。
しかもこの成長の大きなドライバーがClaude Code。Claude Code単体でランレート$2.5B以上。公開6ヶ月で$1Bを突破してる。
ちなみに僕がずっとClaude Codeを推してるのは、使えば分かるけど他のツールと体験が全然違うから。この$30Bは「マーケティングが上手い」じゃなくて「プロダクトの質で選ばれた」結果。
面白いのは、Anthropicが安全性を設立理由にした会社でありながら、売上でもOpenAIに追いつきつつあること。「安全性と収益はトレードオフ」って言われてたけど、実際は逆。安全性を重視する姿勢が企業や開発者の信頼を勝ち取って、それが売上に変わってる。
AI業界で何が起きてるか追いたい人、Anthropicの決算は要チェック。

We've signed an agreement with Google and Broadcom for multiple gigawatts of next-generation TPU capacity, coming online starting in 2027, to train and serve frontier Claude models.
4
2,316
「コーディングが全知識労働を食う」。a16zがポッドキャストの見出しで打ち出した。でもこれ、額面通りに受け取ると本質を見誤る。
正確に言うと「食う」のはコーディングじゃなくて、「意図を構造化して機械に実行させる能力」。この能力は今までプログラマーだけのものだったけど、Claude CodeやCodexの登場で幅広い職種に開放されつつある。
ここで重要なのは、ゲストのPeter Yang(Roblox Product Lead)が「ソロプレナーが増える」と言ってる部分。
①チームが小さくなるのは事実
AIエージェントが開発、分析、カスタマーサポート、コンテンツ制作を代替し始めてる。10人チームが3人になり、3人が1人になる。これは不可逆。
②でも「1人でできる」と「1人で勝てる」は違う
Claude Codeで誰でもアプリが作れるようになった。じゃあ何で差がつくか。ポッドキャストでもここに触れている。「human ambition means there will always be new jobs」。つまり、AIが既存の仕事を効率化する一方で、人間の野心が新しい仕事を作る。
③見落とされてるのは「流通」の壁
作れること自体の価値がゼロに近づくと、最後に残る差別化要因は「誰に、どう届けるか」。プロダクトの品質はAIで横並びになる。勝負は配信力。自分自身がメディアになれるかどうか。
Marc Andreessenも別のエピソードで「VCは人(創業者)に賭ける」と言っている。技術だけでは差がつかない時代、作ったものを届けられるかが問われている。
コードを書く力はAIに任せろ。課題を発見する力と、それを届ける力を磨け。


“Coding will eat all knowledge work”
Peter Yang joins a16z’s Anish Acharya to discuss the post-AI future of work, why AI will create more solopreneurs, why human ambition means there will always be new jobs, and more.
00:00 Intro
01:56 Using OpenClaw for voice, memory & daily life
06:14 Will agents kill apps & SaaS?
11:57 Coding agents: Claude Code vs. Codex
17:00 Future of work: small teams, agents & company culture
24:00 How agents change consumer products & the economy
@petergyang @illscience
これ知ってた? Claude Codeで求職活動を自動化した人が実際に内定取って、そのシステムを丸ごとオープンソースにしてる話。
Career-Opsというプロジェクト。作者のSantiferが740+の求人を自動評価、100+のカスタマイズCV生成を経て、Head of Applied AIとして内定を獲得した。
背景を説明すると、このシステムはClaude Code上で14のスキルモードを搭載した求職自動化プラットフォーム。ただし「完全自動化」ではなく、分析はAI・最終判断は人間というHTIL設計がポイント。以下が主な機能になる。
①企業スキャン
・45+企業のキャリアページを自動巡回(Anthropic, OpenAI, ElevenLabs, Stripe等)
・新規求人を検知したら自動でパイプラインに追加
・常時モニタリングで新着求人を取りこぼさない設計
②求人評価
・A-Fスコアリングシステムで10軸の重み付き評価
・給与レンジ、技術スタック適合度、チーム規模、成長ポテンシャル、リモート可否、企業ステージなどを自動判定
・740+件を一括評価して優先順位をつける。人間には物理的に不可能な量
③CV最適化と応募
・スコアが高い求人ごとにCVを自動カスタマイズ。JDに合わせてスキルの強調ポイントを変える
・Ashby, Greenhouse, Lever, Wellfound等の主要ATSに対応
・Playwrightでフォーム入力を支援し、送信前に必ず人間が確認する設計
・PDF生成、バッチ処理にも対応
④インフラとアーキテクチャ
・Goダッシュボードで全パイプラインを可視化
・14のClaude Codeスキルがそれぞれ独立して動くモード分離型設計
・スキャン専用、評価専用、CV生成専用、フォーム入力専用とスキルを分離
ここで面白いのは「Claude Codeのスキルシステム」の使い方なんだよな。モード分離型のアーキテクチャをClaude Codeの中で実現してて、これはもうClaude Codeを「プログラミング支援ツール」じゃなくて「ワークフロー実行エンジン」として使ってる。コードを書くためのツールでコードを書かないタスクを自動化するっていう逆転の発想。
僕が思うに、この事例は「AIが人間の仕事を奪う」って話じゃない。「人間がAIで自分のキャリア戦略を最適化する」実例。評価基準をAIに教えれば、人間の認知限界を超えた量の求人を処理できる。しかも各求人にパーソナライズしたCVを出せる。求職市場のゲームルールが変わりつつある。
転職活動してる人はもちろん、「Claude Codeで何ができるか」を探ってる人にとっても必見のリポジトリ。これがAIネイティブな求職活動の新しい標準になる。

Bro created an AI job search system for Claude Code that scored 700+ job applications and actually got him a job.
AND IT'S NOW OPEN-SOURCE.
It scans multiple company career pages, rewrites your CV per job, and even fills application forms. The repo has:
> 14 skill modes (evaluate, scan, PDF, ...)
> Go terminal dashboard
> ATS-optimized PDF generation via Playwright
> 45+ companies pre-configured (Anthropic, OpenAI, ElevenLabs, Stripe...)
Giving This Free for 24 hours. To get it:
1. Comment the word 'NEED'
2. Like and Retweet this post
3. Follow me @marryevan999 (so i can DM you)
19
5,390
海外でGemma 4のスマホデモがバズってる。
↓↓↓スペック↓↓↓
・Gemma 4 E2B(MLX最適化)
・iPhone 17 Proで約40トークン/秒(個人デモの計測値)
・128Kコンテキスト
・コーディング、数学、画像理解、シンキングモード
・完全オフライン、APIキー不要
・Google AI Edge Galleryアプリ(iOS/Android)
・Apache 2.0
↓↓↓何がすごいか↓↓↓
・クラウド接続なしで動く → プライバシー完全保護
・アカウント不要 → 誰でも即使える
・商用利用自由 → アプリに組み込み放題
↓↓↓インパクト↓↓↓
スマホ1台でAIエージェントがローカル完結。APIコストゼロ。57億人以上のスマホユーザーがAIホストになりうる世界。
ちなみに僕が先日紹介したGemma 4 Agent Skillsの続きなんだよね。あの時「AIエージェントを使える人口が桁違いに増える」って書いたけど、マジでもう現実になってる。スマホでこの性能が出るなら、「AIが使えない人」がいなくなる日はかなり近い。
みんなはどう思う?
