

Agentic CRM/Agentforceを軸にしたBtoBマーケ・営業のお役立ち情報発信|双日G/法人営業→個人/マーケ→クロスコム/BtoBマーケ|https://xitter.gq/t.co/sVuU97htFz
【note】Agentforceを売上目的で普及させたい理由
Joined August 2020
- Tweets7.4K
- Following328
- Followers641
- Likes31.5K





Pinned Tweet
Agentforceの検証メディア「クロスコム Agentic CRM Lab」を開設しました。
このメディアでは、Agentforce導入による業務変化と投資対効果に焦点を当てていますが、
「AI時代のCRM」を検証とデータから考えるメディアとして、CRMを活用されている企業さまにとって有益なメディアを目指してコンテンツを発信していきます。
🚩なぜこのテーマにしたか
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
CRMにAIエージェントを導入しても、
・業務フローに合わない
・データが揃っていなくて精度が出ない
・出力の確認に想定以上の手間がかかる
といった理由で、PoCから先に進まない企業が少なくないからです。
特に人員や時間が限られている企業にとって、AIエージェントがリソース不足を解決できる手段である一方で、最初のPoC段階で時間を割けないまま検証が止まってしまうケースを見てきました。
なので、自社でAgentforceを動かして検証してきたユースケースをコンテンツとして発信することで、みなさんの業務でそのままご活用いただけるのではないかと考えました。
当社は「100社100通りの購買体験を当たり前にする」のビジョンを掲げていますが、限られた人員でもお客様1人1人の異なる課題に向き合い、最適な解決方法を提案するために、AIエージェントの活用定着は欠かせないと考えています。
なかでも特に重要なのが「CRMデータ」です。
そこで、業務でAgentforceを使って検証を進めてきた当社だからこそ、CRMの側面から企業の業務課題を解決するために、このメディアを立ち上げました。
🚩主なコンテンツ内容
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①導入効果の一次検証
・・・実際に動かして業務がどれだけ変化したか
②業務別の導入ユースケース
・・・営業やマーケの担当・責任者それぞれの業務で何がどう変わるか
③導入事例や調査データの読み解き
・・・業務変化と投資対効果の観点で効果は出ているのか
ーーーーーーーーーーーーーーーーー
Agentforceの導入を検討している企業もすでに導入している企業も、ユースケースの参考情報としてご活用いただけると嬉しいです。

ALT AI時代のCRMを、検証とデータから考える「クロスコム Agentic CRM Lab」
1
11
272
「CRMの入力項目が多いほどAIエージェントの生成に役立つ」と考えている人は多い。
けど、『Ontology Development 101』の論文には、
「オントロジーに、その領域のすべての情報を入れる必要はない」
と書かれています。
この論文では、生物学の実験を記録するオントロジーの例が紹介されています。
↓
実験者も人間なので、生物でもあります。
しかし、実験者を「生物」の下位分類にすると、実験者のレコードに体重や年齢、種といった生物の属性が付いてしまいます。
どれも実験の記録には関係のない属性ですよね。
論文では、こうした分類の追加は「むしろ害になる」とまで書かれています。
CRMシステムでも「いつか分析に使うかもしれない」と考えて作成したレコード項目は、入力されずに使われていないことがあります。
空欄の項目が多いと、営業担当者の入力負担が増えますし、AIエージェントは空欄の意味を判断できないまま読み取ることになるので、不要なものは削除したほうがいい。
1
60
スタンフォード大学の論文『Ontology Development 101』では、オントロジーを作る理由が5つ挙げられています。
①人やソフトウェアの間で情報の構造理解を共有する
②領域の知識を再利用できるようにする
③領域の前提を明示する
④領域の知識を処理の手順から切り離す
⑤領域の知識を分析できるようにする
私は、この中でCRMシステムの運用に最も関係するものを、3「③領域の前提を明示する」だと思っています。
というのも、領域の前提をプログラムの中に直接書き込むと、見つけるのも変更するのも難しくなるからです。
たとえばSalesforceでは、システマティックな機能として次の3か所に領域の前提を書き込んでいる企業が多いと思っています。
・レポートの検索条件:「確度 80以上」
・フローの決定要素:「従業員数 1,000以上 → エンタープライズ担当」
・入力規則の数式:「金額 > 5000000 なら承認必須」
しかしこれらは、設定画面を開かないと誰にも見えませんし、もしこの前提が変わったときは、どのレポートとどのフローに同じ数値が書かれているかを設定担当者が1つずつ探すことになります。
そこで提案したいのは、「カスタムメタデータ型」に領域の前提に当たる"判断基準"を登録する方法です。
.
.
💡手順
 ̄ ̄ ̄ ̄
1.設定 → カスタムメタデータ型 → 新規で「営業判断基準」を作成する
2.項目として「基準名」「値」「説明」を追加する
3.レコードとして「今期見込みの確度下限:80」「エンタープライズの従業員数下限:1000」を登録する
4.フローの決定要素では、数値を直接書かずに「レコードを取得」で営業判断基準の値を読み込む
5.入力規則の数式では $CustomMetadata で値を参照する
.
.
「レポートの検索条件」だけはカスタムメタデータ型を参照できないので、レポートの説明欄に「確度80=営業判断基準の今期見込みの確度下限」と書いておく必要がありますが、
こうしておけば、確度の基準が80から70に変わっても、カスタムメタデータ型のレコードを1件直すだけで済みます。
さらに、営業判断基準を読み込むフローをAgentforceのアクションに登録すれば、AIエージェントも同じ基準を使って判断できるようになります。

2
62
AIの出力精度を高めるために、項目の説明は書いたほうがいい?
オントロジーの記述例にこんな説明文がありました。
「年齢:サンプルの基準時点における満年齢。単位は歳。」
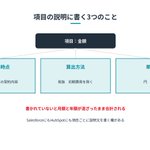
たった1行ですが、ここには以下の3つが書かれています。
・基準時点(いつの値か)
・算出方法(満年齢か数え年か)
・単位(歳)
AIが「年齢」の意味を理解するときに、この説明文をもとに解釈することで、年齢データを生成に正しく活用してくれます。
では、CRMシステムの[金額]項目にはどこまで書かれているでしょうか?
「金額」という項目名だけでは、
税込なのか、税抜なのか?
初期費用を含むのか、年額なのか、月額なのか?
を、AIエージェントは判断できません。
担当者社内のルールや慣習で補って読んでいるんですが、AIにはCRM上に記載されていない情報を補う手段がないんです。
すると、月額と年額の金額が混ざったまま合計されて、もっともらしい数字が返ってくる可能性があります。
SalesforceにもHubSpotにも、項目ごとに説明文を書く欄がありますが、項目を増やすより先に、この説明文に「基準時点・算出方法・単位」を書いておくことが、
地味な作業なんですが、AIの回答の精度に直結する作業だと私は思っています。

2
100
CRMデータでオントロジーを設計するときは、「分類」と「個体」を区別すること。
「犬」は動物の種類を表す分類(クラス)で、
「ポチ」は特定の一匹を指す個体(インスタンス)。
当たり前に見えるんですが、CRMシステムの入力ではこの区別ができていないケースが多いです。
たとえば、
・商談名に「【SaaS】〇〇社 新規」と商材の分類を書く
・取引先名に「〇〇社(代理店経由)」と取引形態を書く
・取引先責任者の氏名欄に「経理ご担当者様」と役職を書く
どれも、個体の名前の中に分類の情報を埋め込んでいる状態です。
人が一覧画面を見る分には便利なんですが、AIエージェントやレポートは「SaaSの商談」「代理店経由の取引先」を分類として扱えません。
文字列の一部から推測させることになるので、表記揺れがあれば取りこぼしてしまいます。
分類は選択リストやカスタムオブジェクトとして別の項目に持ち、名前の欄には個体の名前だけを書く。
この区別ができているCRMシステムほど、AIが条件で絞り込める範囲は広がると思います。

2
115
業種の選択リストにこんな値が入っていないでしょうか。
・製造業
・自動車部品
・食品
・情報通信業
・ソフトウェア
業種を選べるようには見えるんですが、「製造業」と「自動車部品」が同じ階層に置かれています。
オントロジーでは、分類の上下関係を「一種」として定義します。
柴犬は犬の一種で、犬は哺乳類の一種。
この定義があれば、「哺乳類は?」と聞かれたときに柴犬も含めて答えることができます。
CRMシステムの業種も同じです。
「自動車部品は製造業の一種」と定義されていないと、「製造業の受注率は?」というレポートやAIへの質問に、自動車部品の取引先が含まれないわけです。
対策は2つあります。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①上位の業種と下位の業種を、別の項目に分けて持つ(Salesforceの連動選択リストなど)
②日本標準産業分類のように、すでに階層が定義された分類を再利用する
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
自社で分類を作るよりも既存の定義を再利用したほうが、他のデータと照合しやすくなると思います。

25
「CRMシステムに事実データはたくさんあるのに、AIエージェントが意図通りに生成してくれない、、、」
この原因を、オントロジーの公理から考察してみます。
公理とは、推論の前提を形式的に記述したもので、2種類の前提があります。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①一般的な定義:柴犬は犬の一種
②個別の事実:ポチは柴犬
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
この2つの前提があってはじめて、機械は「ポチは犬」という結論を導くことができます。
では、CRMシステムに置き換えるとどうなるでしょうか。
②の事実データは記録されています。
「A社の従業員数は450名」
「A社の業種は製造業」
ところが、①の定義はどこにも書かれていません。
「従業員300名以上の製造業は重点ターゲット」という定義は、営業担当者の頭の中にしかないわけです。
したがい、事実データがどれだけ正確でも、結論を導く前提の半分が欠けているため、AIは「A社は重点ターゲットか?」に答えられません。
AI活用で成果が出ない会社は、事実データの入力ばかりを整えて、定義を書いていないのではないでしょうか。

2
36
データディクショナリ(項目の定義書)を整備したのに、AIエージェントの回答が良くならない。
Salesforceを導入した企業からそんな話を聞きますが、その原因は「用語集とオントロジーの役割の違い」にあると思っています。
用語集は、人に伝わる自然な文章で言葉の意味を揃えるものです。
たとえば「決裁者とは、予算の最終承認を行う人」とかです。
一方でオントロジーには、機械が扱える形式で概念・関係・制約を書きます。
・商談 ―必ず1人持つ→ 決裁者
・決裁者 ―所属する→ 取引先
伝えたい意味は同じでも表現方法が違うわけです。
文章で書いた定義は人が読めば理解できますが、
機械は文章から「どの関係が必須なのか?」「何が何の一種なのか?」を厳密には読み取れません。
広い意味では、用語集もオントロジーに含まれます。
ただ、AIに推論させたいなら、形式的な記述まで進める必要があるでしょう。
だから、データディクショナリを作った会社はまず、
用語集の文章を"関係"と"制約"の形に書き換える
ことを検討してもいいのではないでしょうか。

1
36
「値引きは営業部長の承認が必要」というざっくりの承認ルールを、そのままSalesforceの承認プロセスに設定しようとすると、たいていやり直しが発生する。
10%の値引きでも承認が必要なのか。
既存のお客様でも同じなのか。
前年に1,000万円以上の取引があるお客様は例外なのか。
こうした条件を1つずつ聞いていくと、現場では担当者ごとに判断が違っていたり、そもそも誰も決めていなかったりすることが浮き彫りになってきます。
業務を細かく分解して、システムに渡せる条件として定義する役割を「ビジネスアナリスト」と呼び、国際的にはBABOKという知識体系にまとめられています。
この役割が社内にいないと、テストの段階で「この場合はどうするの?」という例外が次々に見つかって、仕様変更を余儀なくされるケースが止まらないわけです。
.
.
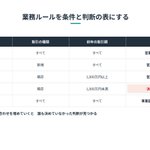
そこで私は、業務ルールをシステムに設定する前に、「条件」と「判断」の組み合わせを1枚の表にしておくのがいいと考えています。
業務分析の分野では、この表を「ディシジョンテーブル(決定表)」と呼びます。
値引きの例なら、
・値引き率
・取引の種類(新規か既存か)
・前年の取引額
を列に並べ、すべての組み合わせについて「誰が判断するか」を埋めていく。
表を埋めていくと、「既存のお客様で、前年の取引額が1,000万円未満、値引き率が10%超20%以下」のように、誰も決めていなかった組み合わせが空欄として発見されるわけです。
こうした空欄が見つかった時点で関係者に決めてもらえば、開発が始まってから例外が見つかる回数は減るでしょう。
そして、CRM上のAIエージェントに値引きの相談を受けさせる場合も、この表があるかどうかで、AIエージェントの回答はまったく変わるはずです。
ルールが文章でしか書かれていなければ、AIエージェントは空欄の部分を自分で推測して埋めてしまう可能性もあるので、注意しましょう。

2
32
マーケティングはMAツール、営業はCRMシステム、カスタマーサクセスはサポートツール、経理は請求システム。
部門ごとに使いやすいツールを選んでると、部門の数だけ同じ顧客が別々のIDとして登録されてしまいます。
たとえば、ABC製作所という1社が、
・MAツール:M-0012
・CRMシステム:001A00
・サポートツール:T-5531
・請求システム:C-2087
のように、4つの別々のIDを持っている状態です。
ツール間をつなぐAPI連携のような設定はあっても、「どのIDが同じ会社を指しているのか」を決める共通のルールがないと、
「問い合わせが多い顧客ほど解約しやすいか?」を検証しようとしても、サポートツールの問い合わせ件数と請求システムの解約情報を、同じ顧客として突き合わせられないわけです。
部門ごとの判断として見れば、どのツールの選定も間違ってはいないんですが、
会社全体のデータの設計図を作成する役割が誰にもないと、部署ごとの最適化が進行して、全体として最適化されていないデータモデリングができあがります。
データ管理の分野では、こうした状態を「データのサイロ化」と呼んでいます。
.
.
そこで私は、ツールを選ぶ前に、全社で共通の顧客IDを1つ決めておくのがいいと考えています。
たとえば、法人のお客様なら国税庁の法人番号。どのツールを導入しても、取引先のレコードに法人番号を必ず持たせることです。
このルールが1つあるだけで、部門ごとにITツールを導入しても、あとから同じ顧客としてデータを管理できる構造になります。
AIエージェントに「解約しそうな顧客」を探させたいなら、まずこの1本の共通IDがあるかどうかを確かめておきたいところです。

1
2
54
CRMシステムの導入をベンダーにまとめて任せた会社では、初期構築後に各種データの構造をドキュメント化していないことが多いと思っています。
たとえば、Salesforceの商談に「重点フラグ」というチェック項目があったとします。
誰がどんな条件でチェックを入れるのか、なぜこの項目が作られたのかを社内の誰も説明できない。
これは、設計した担当者が、導入を担当した「外部の」ベンダーだからです。
本来、こうした設計の判断は、事業の戦略と業務とシステムをモデル化する人材を社内で配置しておくものです。
そのモデル化する人材が社内にいないと、
・項目を作った理由
・オブジェクトの構成
・自動化の条件と例外
といった設計の判断基準が、社内に浸透されないままになるわけです。
その結果、項目を1つ変えるたびにベンダーに見積もりを依頼することになり、変更のコストが毎回かかってしまいます。
もしCRM上のAIエージェントに商談データを読ませるには、各項目の定義と設定基準を、プロンプトや項目の説明として書いておく必要があります。
ところが、項目の意味を社内で説明できなければ、AIエージェントに渡す定義も書けません。
.
.
ベンダーに実装を任せること自体は悪い判断ではないですが、「何を作るか」と「なぜそう作るか」の設計書だけは、ちゃんとドキュメント化することは必要でしょう。

55
AIでROIを生み出す企業になるには、問いから変える必要がある。
誤「AIでどれだけ利益を生み出したか?」
正「AIで顧客の体験価値は上がったか?」
社内のRoiでも、企業利益が上がるということは顧客に価値(変化量)を多く生み出せたかの視点をもつ。
社内のroi算出に顧客の体験価値も巻き込んでるところが、かなり印象的だった。
#SalesforceWorldTourTokyo
#Salesforcetour
1
24
Salesforce World Tourの基調講演。
AI時代における経営組織の変革には、以下のステップ。
4R
①Redesign/業務の再設計
②Reskill/人の再教育
③Redeploy/組織の再配置
④Reballance/全体の再調整
日立やオリコなど、従業員が多くいる大企業が組織変革をこれだけすでに実行していて感じたのは、
規模に関係なく、トップのコミット力と巻き込み力を筆頭に実行していく力があるかないかで、このスピード感を大きく変わる。
特に印象的だったのが、人の価値として残る役割の一つとして「潜在的な経営課題の発見力」。
この潜在的な課題も本当にAIで発見できないかの自問自答しているが、こたえが見つかってない。
顧客の機微な感情や行動の変化を読み取る力が、潜在的な課題の発見につながるのか。
#Salesforcetour
1
3
235

CRMシステムで集計している「企業規模別の受注率」、
もしかしたらその数字は「ねじれた数字」かもしれません。
たとえば、取引先「ABC製作所」の従業員数が
・2024年度:200名(中堅企業)
・2025年度:600名(大企業)
に変わったとします。
営業担当者は2025年4月に取引先の従業員数を600名に更新し、2024年に受注した商談はそのまま残っている場合、
この状態で企業規模別の受注率をレポートにすると、2024年の受注は「大企業の受注」として集計されてしまいます。
これは、商談レポートは取引先の「いまの値」を参照して集計するからですね。
つまり、中堅企業だったころに受注した商談レコードが、大企業の実績として数えられてしまうわけです。
データウェアハウスの設計では、取引先の業種や規模のように、ゆっくり変わっていく属性のことを「緩やかに変化するディメンション(SCD)」と呼びます。
このように、レコード項目の値が変わったときの持ち方をどうすべきか?
大きく2つの型で整理できます。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①上書きする持ち方(タイプ1)
取引先の値を最新に書き換える。SalesforceやHubSpotの取引先の項目は、標準でこの持ち方になっている。
②時点の値を残す持ち方(タイプ2)
値が変更されるたびに「有効開始日」と「有効終了日」をつけて行を分けつつ、過去の値も残す。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
CRMシステムの中で、タイプ2の持ち方をそのまま作るのは手間がかかるので私は
商談レコードを作成した時点の"取引先の業種"や"従業員規模"を、商談レコードの項目にコピーして残しておく
方法がいいと考えています。
Salesforceならフロー、HubSpotならワークフローで、商談を作成したときに取引先レコードの値を商談レコードの項目に写すようにしておけば、過去の商談は「その当時の企業規模」で集計できるようになります。
ただし、どの属性を商談レコードにコピーするかは、事前にルール決めしておく必要があります。
業種、従業員規模、取引先の担当営業など、あとからセグメント別に分析したい属性ほど、コピーしておく価値は大きいでしょう。
そして、CRM上のAI機能で「大企業の商談はどう進めると受注しやすいか?」を分析させる場合、いまの値で集計された商談データを読んでしまうと、
中堅企業だったころの受注した商談データまでを、大企業の勝ち方として学んでしまいます。
AIに商談データを渡す前に、レコードの値が「その当時の値」で読める構造になっているかを確かめておきたいところです。

1
68
CRMシステムの商談データでAIに受注予測をさせるなら、
・その時点で分かっていた値
・あとから入力された値
を区別できるデータ構造にしたほうがいい。
なぜなら、AIが存在しないはずの答えを使って学習してしまうからです。
たとえば、こんな商談があったとします。
・4月1日:商談を作成
・5月10日:提案
・6月20日:失注
・6月21日:営業担当者が「競合:A社」を入力
失注したあとで、営業担当者が商談を振り返りながら競合相手の項目を埋めるのはよくありますよね。
この商談のデータを、いまの商談レコードの値のままAIに読ませると、
AIは「競合の項目が埋まっている商談は失注しやすい」というパターンを見つけるかもしれません。
ところが、競合の項目を入力したのは失注後です。つまり、5月10日の提案の時点では、競合の項目は空欄だったわけです。
機械学習の分野では、予測する時点では手に入らないはずの情報が学習データに混ざってしまうことを「ターゲットリーケージ」と呼びます。
リーケージを含んだままAI学習すると、過去のデータでは高い精度を出すのに、まだ結果の出ていない商談に対する予測は外れ続けてしまいます。
SalesforceやHubSpotの商談データは、失注理由や競合のように結果が出てから埋まる項目が多いので、特にこの問題が起きやすい構造をしていると思っています。
.
.
そこで私は、商談データを次の3つの考え方で設計しておくのがいいと考えています。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①2つの時点を分けて持つ
「事実が成り立っていた時点」と「CRMシステムに記録した時点」を別々に記録する。データ設計の分野ではバイテンポラルと呼ばれる考え方
②項目ごとに「いつ確定する情報か」を決める
失注理由や競合のように、結果が出てから確定する項目には印を付け、予測に使う項目から外す
③過去のある時点の値を復元できるようにする
Salesforceの商談履歴やHubSpotのプロパティの変更履歴を使い、「5月10日の時点で商談レコードがどうなっていたか」を再現して学習に使う
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
③の「ある時点の値を復元する」は、データ分析の分野でポイントインタイムと呼ばれる考え方です。
Salesforceの商談履歴には金額・フェーズ・完了予定日・確度の変更が記録されていますが、独自に追加したカスタム項目は、項目履歴管理をオンにしておかなければ過去の値が残りません。
つまり、AIに学習させたい項目ほど、入力が始まる前に履歴を残す設定とルール決めをしておく必要があるということです。
AgentforceやBreezeに商談の分析を任せる前に、自社の商談データが「その時点の値」で読める構造になっているかを確かめてみてはいかがでしょうか。

3
108
商談の音声や文字起こしの全文を、すべてCRMシステムの商談レコードに貼り付けている会社もあるかもしれません。
実際に1時間の商談を文字に起こすと、数万字になることも珍しくないですよね。
ただ、それを商談の説明欄や活動のメモにそのまま入れていくと、営業担当者が画面を開いても必要な情報にたどり着けず、
CRMシステムのデータ容量も、毎月の商談の数に比例して増えてしまいます。
かといって、要約だけをCRMシステムに残して原文データを入力しないでおくと、あとから「顧客は本当にそう言っていたのか?」と確認できなくなるわけです。
.
.
そこで私は、議事録の原文と商談の記録を、置き場所から分けて設計するのがいいと考えています。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①原文の置き場所
音声データ、文字起こしの全文、メール本文は、共有ドライブやデータ基盤など、CRMシステムの外にまとめて保管する
②取り出す作業
原文からAIが要点の要約と、商談の項目に入れる値の候補を下書きし、個人情報を伏せたうえで営業担当者が確認する
③CRMシステム
商談レコードには、確認済みの項目の値と要約、そして原文の保管場所へのリンクだけを記録する
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
こう分けておくと、CRMシステムの商談画面は軽いまま、原文が必要になったときだけリンクからたどれる構造になります。
原文の保管場所には、CRMシステムとは別に「誰が読めるか」「いつまで残すか」のルールも決めやすいですし、
あと顧客の発言には社外に出せない話が含まれることも多いので、原文を読める人をCRMシステムの利用者より狭く絞っておくのも1つの方法でしょう。
そして、Claudeのような汎用的AIエージェントに商談データの分析をさせる場合も、このデータ設計は効果的だと思います。
AIエージェントは普段は商談レコードの項目と要約を読み、根拠を確かめたいときだけ原文のリンク先を読む。
このように、読む範囲を段階で分けておけば、AIエージェントに渡す情報の量も、見せてよい情報の範囲も、こちらで決められるようになるのではないでしょうか。

2
222
マーケティングからカスタマーサクセスまでが同じCRMシステムを使っていても、「どのデータを誰が作り、誰が更新し、誰が使うのか」が決まっていない会社は多いんじゃないかと思っています。
たとえば、AIエージェントに「失注理由の傾向を分析して」と頼んだとします。
ところが、肝心の「失注理由」の項目は半分以上が空欄。
原因をたどってみると、失注理由を使う人はマーケティング部門とAIエージェントで決まっていたのに、入力する人は誰にも割り当てられていなかったわけです。
これは逆のケースもあって、商談の金額を営業担当者・カスタマーサクセス・AIエージェントの3者が更新できる状態だと、誰の値が最新なのかが分からなくなり、
上書きし合った結果だけが商談レコードに残ってしまいます。
こうした抜けや重なりは、CRMシステムの設定画面を見てるだけでは気づきにくい、、、。
.
.
そこで私は、データごとに「作る・更新する・参照する」担当を1枚の表にまとめておくことをおすすめしています。
データアーキテクチャの分野では、この表を「CRUDマトリクス」と呼びます。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①作る人(Create)
そのデータのレコードや値を最初に入力する部門や役割
②更新する人(Update)
値を書き換えてよい部門や役割
③参照する人(Read)
そのデータを使って判断や作業をする部門や役割
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
表を作ってみると、「参照する人はいるのに作る人がいないデータ」と「更新する人が何人もいるデータ」が、空白と重複として見えてくるでしょう。
前者には入力する担当を決め、後者には更新できる人を1つに絞る。
Salesforceなら項目レベルセキュリティで、HubSpotもプランによってはプロパティごとの編集権限で、更新できる人を実際に制限することができます。
そして、この表にはAIエージェントの列も1つ加えておくのがポイントです。
AIエージェントが参照する項目が空欄だらけなら、分析の結果も空欄の多さに引っ張られますし、
AIエージェントにも更新させる項目があるなら、人とAIエージェントのどちらの値を正とするかを先に決めておかないと、また上書きし合う状態に戻ってしまうのではないでしょうか。

5
99
SalesforceのAgentforceを社内の画面で使うとき、AIエージェントは初期設定では「いまログインしている人の権限」で動きます。
つまり、営業部長がログインしてAIエージェントに頼みごとをすれば、AIエージェントは営業部長と同じ範囲のデータを読み、同じ範囲のデータを書き換えられるわけです。
営業部長は、全営業担当者の商談、取引先責任者の電話番号、商談メモに書かれた社内向けのコメントまで見ることができ、
AIエージェントもそれらを読み取ることができるので、メールの下書きや提案分の作成の際にソースとして使えることになります。
一方で、顧客向けのエージェントなどは、人とは別に用意した「エージェントユーザー」の権限で動きます。
エージェントユーザーには権限セットを割り当てられるので、参照できるオブジェクトや項目、実行できるフローなどを、人の権限とは切り離して絞ることができます。
社内の画面で使うAIエージェントの権限を人と切り離したい場合は、エージェントユーザーで動かす構成にするか、AIエージェントが呼び出すアクション(フローやApex)の側で参照や更新を制限する必要があります。
.
.
どちらの構成をとるにしても、私はAIエージェントの権限を次の3つに分けてルール決めしておくのがいいと考えています。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①読める範囲
取引先、商談、活動履歴は読めるようにする一方で、取引先責任者の電話番号や個人のメモなど、作業に必要のない項目は見せない
②書ける範囲
取引先や商談などの事実データは書き換えさせず、カスタムオブジェクト「仮説」などに下書きとしてだけ書き込ませる
③実行できる範囲
顧客へのメール送信や項目の更新は、人が承認してから実行する
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
人の権限は「その人の役職で何を見てよいか」を基準に決められていますが、AIエージェントの権限は「その作業に何が必要か」を基準に決める必要があります。
この3つを分けておけば、AIエージェントが事実データを書き換えてしまうことを防げますし、AIエージェントの下書きを人が直した差分も記録として残すことができます。
そして、AIエージェントが読める範囲が決まっていれば、「この提案はどのデータをもとに作られたのか」を、営業担当者があとから確かめられるようになります。


3
181
SalesforceやHubSpotにAI機能を入れる前に、CRMシステムの中を「記録・判断・実行」の3つの層に分けて考えたほうがいいと思っています。
ふだん使っている画面に置き換えると、3つの層は次のようになります。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①記録の層
Salesforceの取引先・取引先責任者・商談・活動、HubSpotの会社・コンタクト・取引・アクティビティなど、標準オブジェクトに入る事実データ
②判断の層
「この商談の本質課題は何か」「決裁者は誰か」といった仮説と、その根拠、商談後の検証結果
③実行の層
ToDo、メール、Salesforceのフロー、HubSpotのワークフロー、AgentforceやBreezeなどのAIエージェントの作業
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①と③は、どちらのCRMシステムにも標準オブジェクトや標準の機能として最初から用意されていますが、
②の仮説や検証結果を記録するための標準オブジェクトは、SalesforceにもHubSpotにもありません。
そのため、CRMシステムに
事実:商談金額500万円、次回打ち合わせ11月20日
行動:ToDo「11月18日までに提案書を送付」
と記録されていても、「なぜ提案書を送るのか」「どんな見立てでその行動を選んだのか」は、どこにも記録されません。
つまり、いまのCRMシステムは「事実から行動へ直接つながる構造になっている」わけです。
.
.
そこで私は、判断の層を「仮説」というカスタムオブジェクトとして作り、商談オブジェクトに関連付けるのがいいと考えています。
商談を親、仮説を子にして、1件の商談に複数の仮説がひもづく「1対多」の関係にします。
たとえば、1件の商談に次の2つの仮説がひもづくイメージです。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
仮説①(11月1日)
内容:現場の工数削減が一番の関心事ではないか
検証結果:外れ(現場は困っておらず、経営陣の意向だった)
仮説②(11月10日)
内容:情報システム部門のセキュリティ審査が関門ではないか
根拠:11月10日の商談メモ(担当者が承認プロセスの話で言葉を濁した)
検証結果:的中(11月15日の電話で確認)
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
なぜ、商談オブジェクトに「仮説」というテキスト項目を1つ足すだけでは足りないのか?
理由は2つあります。
1つ目は、項目だと仮説が変わるたびに上書きされて、仮説①のような外れた見立てが消えてしまうからです。
2つ目は、仮説を1件ずつのレコードにしておけば、「的中した仮説」「外れた仮説」を商談をまたいで集計できるからです。
.
.
設定の方法は、
Salesforce:カスタムオブジェクト「仮説」を作り、参照関係または主従関係の項目で関連先に商談を指定する
HubSpot(Enterpriseプラン):カスタムオブジェクト「仮説」を作り、取引との関連付けを有効にする
これで、商談の詳細画面に活動履歴と並んで「仮説」の一覧が表示されるようになります。
営業担当者は、商談が終わったら商談画面の「仮説」から新規作成で仮説を登録し、次の商談で結果が分かったら、その仮説を開いて検証結果を「的中」か「外れ」に更新します。
そして、AgentforceやBreezeのようなAIエージェントを動かす場合、仮説の記録がなければ、AIエージェントは事実データから直接、次の行動を提案することになります。
仮説と検証結果のレコードが貯まっていれば、AIエージェントは「過去に情報システム部門が関門になった商談で、何を確かめ、どんな結果だったか」を参照したうえで、次の行動を提案できるようになるでしょう。


2
112
CRMレコードの選択リスト項目は、年度の途中や期の切り替わりで見直すことが多いので、値を変更するときのルール決めをしておかないと、過去のデータと比較できなくなります。
たとえば、失注理由の選択肢を2025年度は
・価格
・競合
・タイミング
の3つで運用していた会社が、2026年度から
・価格
・競合(機能差)
・競合(価格差)
・予算が確保できない
・導入時期の見送り
の5つに細かく分け直したとします。
選択肢を細かくすること自体は、失注の背景情報を詳しく残すうえで意味がありますが、
変更するときに古い値を削除したり、過去のレコードの値を手作業で書き換えたりすると、「2025年度と2026年度で、競合に負けた商談の割合はどう変わったか」を集計できなくなります。
2025年度の「タイミング」が、2026年度のどの選択肢にあたるのかが記録されていないからです。
.
.
そこで私は、選択リストの値を変更するときに、次の3つをルール決めしておくのがいいと考えています。
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
①古い値は削除せずに無効化する
新しい商談では選べないようにして、過去のレコードには古い値をそのまま残す
②変更日を記録する
いつから新しい選択肢で入力しているかを、項目の説明欄や管理用の記録に残す
③新旧の対応表を作る
「競合」→「競合(機能差)」「競合(価格差)」のように、古い値と新しい値の対応を1つの表にまとめておく
 ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄ ̄
対応表があれば、年度をまたいで集計するときに新しい選択肢を古い区分にまとめ直して比較できます。
逆に、古い区分を新しい区分に分け直すことはできないので、選択肢は最初から細かめに設計しておいたほうが、あとで比較しやすくなるでしょう。
そして、CRMシステムにAI機能を入れる場合も、AIは選択リストの値を文字どおりに読み取れます。
対応表がなければ、AIは2025年度の「タイミング」と2026年度の「導入時期の見送り」を別の失注理由として扱い、年度をまたいだ傾向の変化を読み違えることになるので、注意しておきたいです。

2
108