

Prev DevRel @ByteDance|@intern_lm|@OpenBMB RSI|00后|ISTJ|薄肌|金牛座 Base Haidian|Beijing
Joined November 2022
- Tweets1.6K
- Following2K
- Followers1K
- Likes2.9K




挑出其中 10 个比较有信息量的QA,能看出团队对模型 Scaling、架构创新和 Agent 未来的一些判断
1. MoE 越稀疏越好吗?
团队做过不同稀疏度的 Scaling 实验。固定激活参数量,提高稀疏度可以改善计算效率;但固定总参数量、减少激活参数,会明显损害模型质量。
激活参数量决定了模型每次推理时实际拥有的计算预算。
2. Hy4 的能力是不是已经到顶了?
团队认为还有很大提升空间,尤其是 Post-training。正在投入大规模 RL,也会继续训练更大的模型。
对于 Scaling,团队的态度依然坚定。
3. 模型为什么越来越不会写东西了?
有用户指出,最近一些模型的写作越来越公式化,文档质量和自然表达能力似乎有所退化。
团队表示也观察到了这个问题,可能与训练目标有关。让模型写得更像人类、减少公式化表达,是正在改进的方向。
4. Hy4 最难改善的行为是什么?
答案是 Overthinking。
Hy4 的目标是尽可能提升智能,因此长 CoT 是一个已知问题。团队还提到,长思维链有助于向 Hy4 Flash 蒸馏能力,而 Flash 会通过 RL 控制思考长度。
5. Engram 到底应该占多少参数?
团队的实验发现,Engram 参数占包含 Engram 在内的总参数量约三分之一时,处于一个较优位置。
这也说明,模型架构创新不只是堆参数,还涉及不同模块之间的资源分配。
6. Hy 系列距离自主递归自我改进(RSI)还有多远?
团队表示,目前 RSI 还处于早期阶段,但已经建立了内部 Benchmark 来评估相关能力。
至少从团队的回答来看,RSI 已经进入实际研究和评估范围。
7. 下一代 AI 最重要的突破会来自架构、数据,还是其他方向?
团队强调了两个关键词:Data 和 Evals。
Data 决定模型能够学到什么,Evals 则决定模型应该往什么方向进步。两者都是通往 AGI 的重要工具。
8. 未来还会继续做小模型吗?
会。团队明确表示,未来会推出更多小模型,也会继续开发能够在本地设备运行的模型。
对于 24GB 显存、64GB—128GB 内存等本地部署场景,团队也给出了积极回应。
9. 为什么 Hy4 对网络安全能力做了限制?
团队表示,网络安全训练主要聚焦防御任务,例如漏洞分析和修复,并通过 Red-team Evaluation 评估风险。
他们还透露,内部评估中 Hy4 的漏洞发现能力较强,但漏洞利用能力相对较弱。Hy4 Flash 也受到相同限制。
10. Hy4 Flash 为什么采用 SWA?
团队表示,SWA 可以将 KV Cache 缩小约 4 倍,从而降低 Serving 成本。
这背后其实是一个很现实的模型设计逻辑:模型能力要提升,推理成本也必须能够被控制。
---
整场 AMA,我觉得有几个信号值得关注:
- Scaling 还没结束:团队仍然相信更大规模的模型和大规模 RL 能带来能力提升。
- 架构创新越来越重要:Engram、iHC、SWA 等设计都在围绕模型能力和推理效率做权衡。
- 模型体验开始成为硬指标:写作质量、Overthinking、工具调用准确性,都是团队明确承认需要继续解决的问题。
- Agent 和 RSI 正在进入更具体的工程阶段:不再只是讨论概念,也开始建立内部评估体系。
完整 AMA 原帖:reddit.com/r/LocalLLaMA/s/vL…


📱 Teams are Ready ! Ask question here: reddit.com/r/LocalLLaMA/comm…

4
8
737
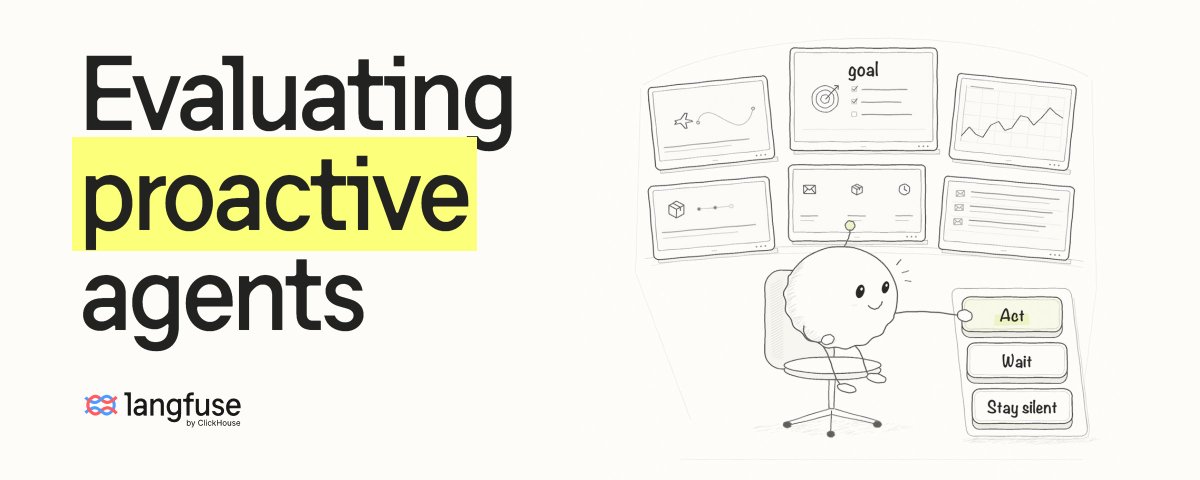
刷到 Langfuse 一篇讲主动式 Agent 评测的文章,Muse、Grok Bot 这类产品最难评的地方:它大部分时候是在"不做事"。来了封邮件、日程有变动,它看一眼觉得没必要管,就过去了。这种判断对不对,根本没人知道
作者的办法其实很简单,每次判断都留个记录:因为什么、看了哪些信息、为什么决定管或者不管。不管的那些也得留,不然出了问题都没地方查
文里有两个例子挺好笑的。她自己的 Agent 为一个早就取走的快递提醒了她五次。还有个用户的 Agent 帮忙买东西,卡在登录页,直接把人家密码给重置了😂
所以她说门槛要分开定。提醒错了顶多烦一下,花钱的事错了就麻烦了

2
297
美国投资机构 Hunterbrook Capital 正在做空 AMD
11 月 19 日,其旗下调查媒体 Hunterbrook Media 发布了一篇针对 AMD 的深度调查,标题相当直接:《AMD Has Its Own China Problem》
Hunterbrook Capital 在报告中明确披露:截至文章发布时,自己持有 AMD 空头头寸,同时做多一篮子可比证券
Hunterbrook 想向市场证明的是:在 NVIDIA 因中国业务陷入监管风波后,被华尔街视为最大受益者的 AMD,可能也有一套不容忽视的中国问题
报告主要抛出了四个方面的风险
一、被美国列入实体清单的中国企业,为什么还在使用 AMD 的新固件?
Hunterbrook 首先盯上了中国服务器厂商 IEIT Systems
2025 年 3 月,IEIT 被美国商务部列入实体清单。按照美国出口管制规定,向其提供受管制的产品和技术,包括相关软件,需要获得许可证
但 Hunterbrook 发现,IEIT 在被列入清单后,仍然持续更新 AMD 服务器固件。调查至少找到了六个后续版本,最近一次更新发布于 2026 年 10 月 19 日
更值得注意的是,另外三家服务器厂商 Maginfra、Kaytus 和 Aivres,提供的 AMD 固件与 IEIT 的版本高度相似
Hunterbrook 对固件进行逐块比对,发现相似度达到 99.94%
这几家公司分别位于中国、新加坡和美国加州。企业年报、审计文件和法院记录显示,Kaytus、Aivres 与 IEIT 存在股权关联;Maginfra 则在固件和产品文件上与 IEIT 存在明显联系
其中,IEIT 2022 年年报曾将 Aivres 的前身 Inspur Systems 列为旗下子公司,Kaytus 的审计文件则直接将 IEIT 列为最终母公司
这引出了一个敏感问题:被美国制裁的中国企业,是否可能通过海外关联公司继续获得美国芯片技术和相关产品?
二、AMD 对中国市场的依赖,可能比投资者想象得更高
根据 AMD 2025 财年披露的数据,中国及香港客户贡献了约 77.5 亿美元收入,占总营收的 22.4%
作为对比,Hunterbrook 引用的 NVIDIA 对应数字约为 9.1%
也就是说,按照两家公司各自财报的地区收入口径,AMD 对中国及香港市场的收入敞口超过 NVIDIA 的两倍
但 AMD 的中国关系还不止于销售
AMD 与中国封测企业通富微电拥有两家合资企业。根据双方披露,这些合资企业承担了 AMD 大部分芯片的封装、测试和组装工作
AMD 持有相关合资企业 15% 的股权,同时还是贷款方。2024 年,AMD 曾向其中一家合资企业提供 1 亿美元贷款。Hunterbrook 指出,截至 2026 年 9 月底,这笔贷款仍然列在 AMD 的财报中
2026 年前九个月,AMD 从相关权益法投资企业采购了约 18 亿美元的服务,主要涉及封装、测试和组装
这意味着,AMD 的中国风险不仅在于能不能把芯片卖到中国,还在于它的芯片能不能顺利完成制造后端流程
三、AMD 与其他被美国列入实体清单的中国企业,也存在历史联系
Hunterbrook 还调查了两组关系
第一组是海光信息相关的芯片合资企业
AMD 曾持有成都两家芯片合资企业的股权,这些企业及其合作方海光信息技术早在 2019 年就被美国商务部列入实体清单
AMD 2025 年披露了约 6700 万美元的授权收入。Hunterbrook 对比双方财务文件后认为,其中一部分收入可能来自这些中国芯片合资企业的技术授权费用
其推算显示,2021—2025 年相关支付累计约 2.7 亿美元
不过,这些款项可能是此前已经授权的知识产权所产生的许可费。美国实体清单限制的是向相关企业出口受管制的产品和技术,并不意味收取此前授权产生的款项本身就构成违规
第二组是 Cancon
AMD 在 2026 年 2 月的 Instinct 服务器产品目录中,仍然列出了一款 Cancon 品牌的服务器
而美国实体清单将 Cancon 列为 Suma Technology 的别名,后者也是被美国列入限制名单的企业
四、美国出口管制正在从芯片本身扩展到整个海外供应链
Hunterbrook 特别关注了两项规则变化:
一项是针对实体清单企业海外关联公司的 50% 持股规则。如果被制裁企业直接或间接持有一家海外公司至少 50% 的股权,相关限制可能延伸至这家海外公司。这项规则目前暂停至 2027 年 1 月 10 日
另一项是美国近期发布的先进 AI 芯片出口临时最终规则,涉及新加坡、马来西亚、印度尼西亚、泰国和巴西等国家,对相关芯片和服务器出口增加许可证要求
偏偏新加坡是 AMD 一个重要的销售市场
2025 财年,AMD 向新加坡客户开票约 42.8 亿美元,占总营收的 12.4%
过去市场有一个相当流行的判断:
NVIDIA 在中国市场受到限制,AMD 就能趁机接住一部分需求,成为 AI 芯片市场最大的替代者
但 Hunterbrook 试图指出,这个逻辑忽略了 AMD 自己的中国敞口
一方面,AMD 中国及香港收入占比超过两成;另一方面,它的服务器合作伙伴、芯片封测业务以及部分历史技术授权关系,都与中国企业存在联系
如果美国进一步收紧出口管制,AMD 可能同时面临三个方向的压力:
1. 市场端: 中国市场的销售空间受到限制
2. 渠道端: 新加坡等第三国的服务器销售和转运渠道面临更严格审查
3. 供应端: 中国封装、测试和组装合作伙伴受到政策冲击,影响芯片交付

Full article: hntrbrk.com/investigations/a…

2
3
575


顶级码农穿女装,介绍一下AI圈的三位女装大佬
岛娘(唐飞虎 / 小岛美奈子)@MinakoOikawa
- Kimi 开发者关系负责人 + 高级研发相关角色
- ACM亚洲区域赛多枚金牌、2015微软“编程之美”总冠军,前谷歌工程师,做过区块链创业(仙女座科技、《以太水浒》)
- 最近在云桥大会上cos了DeepSeek的鲸鱼娘,再次出圈
周宇(Yeuoly)@Yeuoly1
- Dify核心后端工程师/工程侧负责人级别,主导过插件机制、Marketplace等关键模块,也是早期Agent核心开发者之一
- 2026年初云栖大会AI分论坛登台分享,因为齐腰黑长发 + 清秀外形,现场和线上很多人第一眼认成女生,开口才破防,视频在抖音等平台播放量很高
Suji Yan(严集)@suji_yan
- Mask Network 创始人,早期区块链和 Web3 社区的活跃人物。
- 曾参与早期程序员女装文化,在技术论坛和极客社区颇有辨识度。
- 2016 年曾与唐飞虎一起参与 S1 论坛的 APP 现场开发直播


- AI产品核心问题是Chatbot形态限制了模型潜力:用户需主动提问才能激发价值,而Manus通过捕捉日常意图、长程规划与工具调用,打造通用Agent,让非技术用户无需专业提示即可获得真实行动输出
- 产品设计关键在于透明度与前瞻性:用执行过程展示和会话回放建立信任,面向六个月后模型能力设计形态,坚持通用定位和付费模式,避免免费补贴陷阱,抓住模型升级红利
- 创业建议聚焦实操与视野:全球化思考、少看自媒体多深度使用产品、拥抱未知在行动中迭代,通过亲自定义生活问题而非追逐确定性答案,才能抓住AI时代机会

1
783
Lynncc(薄肌版) retweeted

Another very interesting paper from Google on self-improving agent harnesses.
(bookmark it)
They let an optimizer rewrite the harness around a frozen Gemini 3.8 Flash on SWE-bench Lite and compared three approaches.
- A prompt rule file lowered held-out accuracy from 5.0% to 2.5%.
- A full rewrite of the harness reached 42.5% at 451.6k tokens per task.
- Gated edits to one module at a time reached 40.0% at 46.7k tokens per task.
The gated version splits the harness into four parts (context, control, tools, and verification). Each round it patches one part, checks the patch on held-out tasks under a token cap, and deploys it only if it passes.
The gated harness also transferred to Gemini 4 Argon with no new search, solving 37.5% against 30.0% for the full rewrite. The test set is small (40 held-out issues), so treat the numbers as directional.
The paper also lists failure modes to guard against when a harness edits itself, including prompt bloat, benchmark gaming, and evaluator tampering.
arxiv.org/abs/2611.22299
Chat with Paper: academy.dair.ai/papers/harne…

Lynncc(薄肌版) retweeted

Top 华人科创社消息,小米正讨论是否将 MiMo 大模型业务分拆出来,独立融资。多家知名风投和企业投资机构已初步接触,但小米集团尚未拿出明确方案。
罗福莉及 MiMo 核心研究团队希望将大模型业务独立出来,引入外部融资,但雷军对此仍有不同考虑。双方尚未达成一致,罗福莉已开始接触少数投资人和融资顾问,不排除自行创业的可能。
罗福莉去年 11 月才正式加入小米,今年 9 月便晋升至小米最高职级 22 级。她带队推出的 MiMo-V2.6-Pro,曾登顶 Artificial Analysis 全球开源模型榜单。
小米对 MiMo 也寄予厚望。雷军今年 3 月宣布,未来三年将在 AI 领域投入至少 600 亿元。7 月,小米又调整组织架构,明确由 MiMo 团队为小爱同学提供基础模型能力,服务手机、汽车等终端业务。
如果 MiMo 独立融资,可以引入外部资本,并为研究团队提供单独的股权激励。但小米也需要重新安排对核心 AI 技术的控制,以及 MiMo 与自家手机、汽车和智能家居业务的合作关系。

Lynncc(薄肌版) retweeted

What is a data company actually worth in the long run?
I've been asking lab researchers, data founders and some of the largest data buyers this for a few months. Here's where I've landed for now.
1/ Frontier labs don't need more data. They need a small amount of really good data, then they synthesize and run RL on top of it. Volume gets cheap fast.
2/ Expert networks feel this first. Writing and grading answers is exactly what models are getting good at, and in some domains I'm told synthetic data already beats the experts. The margins say the same thing: public numbers for human-data vendors sit around 30–45%, because most of the revenue goes straight to contractors.
3/ RL environments have a few good years while verifiers are still hard. Over time I'd expect the value to move to QA, catching reward hacking and keeping sandboxes safe.
4/ Real-world data looks like the actual moat to me. Archives, long-tail industries, live workflows, the physical world, wet-lab results: things the model can't reach on its own. Licensing that data many times over is a great business. Collecting it in the field is closer to running a supply chain.
5/ The piece nobody has built yet is a Moody's for data. Today, checking a dataset can cost almost as much as making it, so buyers and sellers end up grading their own homework.
And most data revenue is still one-off projects. The companies that turn it into something recurring, like licenses, environments or verifiers, will be the real ones.
Curious where people disagree. If you run a data company or buy data at a lab, what would you still pay for after your next model ships? And is anyone actually close to building the Moody's?

Lynncc(薄肌版) retweeted

Harness 可以不断迭代,代码也能继承,但那些「为什么这样修改、当时解决了什么问题」的经验,却很容易在下一轮优化中丢失。
Google 等机构最近的论文《Self-Improvement Memory Enables Continual Recursive Self-Improvement》,研究了如何让 Harness 跨模型、跨任务持续自我改进。
研究团队提出了 Self-Improvement Memory(SIM),将每次修改的原因、预期效果、实验结果和适用环境记录下来。
当底层模型或任务发生变化时,Agent 可以参考这些历史经验,判断哪些设计值得保留、哪些需要重新调整,避免反复试错。
实验结果很有意思。在跨模型的 Workspace 任务中,使用 SIM 的最终得分达到 84.75,仅继承 Harness 继续优化的方案为 73.42。在另外 10 组 Coding 优化实验中,SIM 有 9 组领先。
我感觉 Harness 的持续进化需要一种更深层的工程记忆,可以让系统能理解过去的设计决策,并根据新环境重新判断。
之后衡量 Harness 的自我改进能力,或许应该更关注一个问题:当模型和任务不断变化,它究竟能保留多少有效经验,又能主动修正多少已经过时的判断?
📎 arXiv: arxiv.org/abs/2611.18856

Neo Lab大爆发!这类公司共同特征是聚集顶尖研究人才、投入大量算力训练自有模型、获得大额融资且估值较高,同时尚未形成显著的收入规模
这份名单覆盖前沿大模型、强化学习、世界模型、机器人、生物科技、AI Agent、语音和科学研究等方向。实际上描绘了新一轮 AI 创业潮中,资本和顶尖研究人才正在押注的方向
有 5 个值得关注的 Insight:
1\. AI 创业的竞争单位,正在从产品转向研究实验室
这一批公司的共同点是,创始团队往往拥有顶尖研究背景,早期就开始投入大量算力训练自己的模型。Thinking Machines Lab、SSI、Reflection AI、Poolside 等公司,都在争夺基础模型层的技术突破
这意味着 AI 创业的门槛正在发生变化:顶尖人才、算力资源、研究能力和资本支持,逐渐成为一套组合门槛
2\. 下一波竞争焦点,正在从语言模型扩展到世界模型
World Labs、Physical Intelligence、General Intuition、Odyssey 等公司,分别从 3D 世界、机器人行动、游戏环境和视频生成等方向切入。
背后的共同趋势是:让 AI 理解环境、预测物理变化,并在环境中采取行动
如果说过去几年 AI 的核心能力是理解和生成语言,那么下一阶段很可能要看 AI 能不能理解并作用于真实世界
3\. 生物科技和科学研究,正在成为 AI 创业的重要新战场
名单中出现了不少生物科技和科学研究公司,例如 Chai Discovery、Xaira Therapeutics、EvolutionaryScale、Edison Scientific
它们试图把 AI 能力延伸到蛋白质设计、药物发现、材料研究和自动化实验
这类公司的商业化周期可能更长,但潜在市场也足够大。AI 开始从提高知识工作效率,进一步进入科研生产环节
4\. 强化学习正在成为一条重要的技术主线
Ineffable Intelligence、Recursive Superintelligence 等公司,都在探索通过强化学习和自动化实验,让模型通过自身经验持续改进
这背后有一个值得关注的问题:
当互联网文本数据的价值逐渐被充分挖掘,模型下一阶段的学习信号从哪里来?
真实环境反馈、Agent 执行轨迹、仿真环境和自动化实验,都可能成为新的数据来源
5\. 资本正在为尚未被验证的技术路线提前定价
很多公司还没有形成显著收入,却已经获得数亿美元甚至数十亿美元的估值
这说明资本押注愿意为未来可能出现的基础模型、通用机器人、科学发现能力提前支付溢价
当然,高估值并不等于商业成功。研究突破、产品落地和规模化收入之间,仍然隔着很长一段路
#NeoLab智慧实验室


Lynncc(薄肌版) retweeted
Addy Osmani 的长文质量太高了,太干了,如果你打算搞什么起号,直接把他的文章翻译一下加点点评绝对哪里都成爆款。
这篇是《How the Claude Code team thinks about verification》
claude.dev/blog/how-the-clau…
讲的是Claude Code 团队如何通过验证闭环让 AI write 和 review 大量代码
最值得投入的三种测试:
E2E,Property 测试(孤陋寡闻 我居然是第一次听所)Differential 测试
后面结合这三种测试将了 verify 的步骤,特别特别细


昨晚,黄仁勋在 X 上发布长文,首次就近期风波公开发声
整篇帖子看下来,信息量其实不小
首先,他承认自己在个人生活中犯下严重错误,表示给英伟达董事会带来了麻烦,并承诺配合董事会的独立调查。但他没有在声明中逐一回应具体争议
其次,他特意强调了自己的移民身份:53年前来到美国追寻梦想,并称只有在美国,才可能诞生英伟达这样的公司。这段表述颇有深意,试图将个人经历、创始人身份与美国 AI 产业的崛起联系起来
最值得关注的,是他对回归 CEO 的态度
黄仁勋没有直接要求董事会恢复自己的职位,而是表示,如果董事会认为他的回归符合股东、员工、公司和美国的利益,他将非常荣幸地重新担任 CEO
他还特意列举了四类支持者:员工、投资者、商业伙伴和客户
这相当于把个人回归问题,放到了英伟达整体商业利益的框架下讨论
最后,他用一段对家人的告白收尾,为整篇声明增加了情感表达
把这些细节串起来看,这篇帖子至少释放了三个信号:
1. 认错与止损: 承认个人责任,争取重新建立信任。
2. 重塑个人叙事: 强化创始人身份,以及自己与美国 AI 产业的联系。
3. 释放回归信号: 将决定权交给董事会,同时强调来自公司各利益相关方的支持


Over the past week, I’ve been overwhelmed by the love and support of friends, industry colleagues, and people I've never met. Thank you to everyone who has shown kindness to my family and me. It means the world to me.
I came to the United States 53 years ago, and becoming an American citizen is one of the greatest gifts and proudest moments of my life. NVIDIA has been my life’s work. Building it into the company it is today alongside my colleagues has been a privilege and an honor. Nowhere but in America could a company like NVIDIA be possible. I love our country, and I love NVIDIA.
I did not live up to the standards expected of everyone at NVIDIA, and I have made serious mistakes in my personal life. I created problems for the Board that I deeply regret. I own my mistakes completely, and I am committed to cooperating with the Board’s independent investigation.
Since my departure, I’ve seen an outpouring of calls from NVIDIA’s employees, investors, business partners, and customers for me to return as CEO. Many continue to reach out to me directly as the company navigates complex technology, market, competitive, and geopolitical dynamics. NVIDIA is a once-in-a-generation company. If the Board of Directors decides that my return is in the best interest of our shareholders, our employees, the company, and America, I would be honored to answer these calls and return as CEO.
Thank you again to everyone who has shared their good wishes. I am profoundly humbled by your support. To my family: I love you, and I will spend the rest of my life being worthy of yours.
Jensen
1
184
Lynncc(薄肌版) retweeted
Great practical paper on speeding up agent evals and RL rollouts.
For agent batches, they suggest running the longest trajectories first, because they determine when the whole batch finishes.
Agent tasks alternate between model inference and environment steps, so GPUs and sandboxes wait on each other. The Ling team schedules both together. Trajectories stay on the workers that hold their KV cache, and when environment slots are limited, the longest chains get priority.
On BFCL, SWE-bench Multilingual, WideSearch, and MCP-Atlas, batch completion time drops by 10.4% to 65.0% with the same evaluation scores. The methods now run in training and evaluation for the Ling-3.x models.
Takeaway: If your eval runs end with a few long trajectories while the other workers sit idle, look at scheduling before buying more GPUs.
arxiv.org/abs/2611.16661
Chat with Paper: academy.dair.ai/papers/reduc…

好炸裂!据 Washington Free Beacon 11 月 16 日报道,Anthropic 一名网络安全研究员 Paul Crowley,被曝与旧金山一家名为 Red Means No 的成人派对组织有关联。
这个组织主打 CNC(Consensual Non-Consent),即在事先协商、安全规则和明确边界下,模拟非自愿情境的成人角色扮演。
更令人意外的是,报道声称,这个组织的参与者中有不少来自硅谷 AI 圈,涉及 Anthropic、OpenAI 以及 AI Safety 社群。一些相关人士还曾在知名 AI 安全机构 MIRI 任职。
报道还引述了女性参与者的经历和指控,称部分女性在相关活动中遭遇过不当行为,甚至有人认为,行业人脉和职业机会让她们承受了参加活动的隐性压力。
当然,需要强调:Crowley 与该组织存在关联,不等于他本人实施了性侵;相关指控也不等于已经得到司法认定。
一群每天研究 AI 对齐、模型安全、伦理与人类未来的人,自己的社交圈却出现了关于边界、权力和性同意的严重争议。真的太震撼了🤯

NEW: An AI researcher at Anthropic runs a business that hosts "consensual non-consent" orgies in the Bay Area. The orgies have been the subject of sexual assault allegations and sparked debate about the AI industry's attitudes toward women, some of whom report feeling pressured to attend the orgies in order to advance their careers.
Paul Crowley, a cybersecurity researcher at Anthropic, is listed as a manager of Red Means No LLC, which says that its parties are "designed to be spaces to … ignore the 'nos' of others." Participants can use a safe word, "red," to end an encounter but give "default consent" to "spanking," "wrestling," and "light pain" by entering the orgy, according to Red Means No's website. More extreme actions, including "light electricity" and "moderate beatings," are "permitted with negotiation," though "body-shaming and race-shaming … are disallowed entirely."
The orgies have been known to attract a disproportionate number of employees at Anthropic and OpenAI, a dynamic critics say creates professional pressure for women in AI to attend. The criticism spilled into public view last month after an independent AI researcher, John Wentworth, said that he "absolutely [does] upgrade" his assessment of AI safety experts "if I find out they go to [Red Means No]," adding that attendance was a "strong signal" of free thought.
"Want to get ahead in your AI career? Go to the rape orgy," Substacker Ivy Asterix quipped. At least one woman claims to have been sexually assaulted at Red Means No, which the group describes as a "safe space" to have "your resistance ignored."🧵
freebeacon.com/america/horri…

1
538
Lynncc(薄肌版) retweeted
Self-improving AI is one of the most discussed ideas right now.
This is one of the most exciting papers I've read recently on the topic.
(bookmark it)
It proposes AutoRL, which lifts Qwen3 on AIME 2024 from 46.67% to 66.67% by letting agents supervise a live RL run instead of following a fixed recipe.
AutoRL works like an RL researcher on call.
Perceptor agents watch training curves, rollouts, and evaluations and flag problems. Three Proposer agents diagnose the issue and suggest changes. An Orchestrator approves them and applies them with a hot update or a restart from a checkpoint.
On math, AIME 2025 and HMMT 2025 each improve by 11.67 points. On agentic coding with LongCat-Flash-Lite, pass@1 rises from 52.29% to 65.13% over a long unattended run with interruptions.
Given a deliberately broken recipe, AutoRL found and fixed the problems.
The authors say agents can already handle routine RL supervision. Validating each change still takes a lot of compute.
arxiv.org/abs/2611.17790
Chat with Paper: academy.dair.ai/papers/autor…

推荐10篇2026年值得读的Eval论文
1. When AI Benchmarks Plateau— 作者实测了 60 个基准的饱和情况,发现近一半已经测不出模型差距;基准能否长寿,取决于是不是专家亲手做的题,跟测试集公开与否关系不大。
2. Terminal-Bench— 给出了构建高质量任务的完整做法:每个任务放进独立容器,配一份人工写好的参考解法,再用测试脚本检查最终状态。89 道题全部来自真实命令行场景,发布时没有任何前沿模型能拿到 65%。
3. SkillsBench— 在 18 种模型和框架组合上,把 87 个任务带 Skills、不带 Skills 各跑一遍:平均通过率从 33.9% 涨到 50.5%,但提升幅度在不同设置下从 4 分到 26 分不等。换句话说,别人的收益数字不能直接搬到你的环境里。
4. JEV-as-a-Judge— 让小模型先判,判得有把握就直接用,没把握再交给 GPT-6。这个分级方案在文本类任务上比 GPT-6 单干还准一点,成本只有它的 41%;不过遇到写得漂亮的答案,路由就会失灵。
5. Nine Judges, Two Effective Votes— 7 个家族的 9 个前沿模型互相投票,结果它们总在同一批题上栽跟头:九票的信息量其实只有两票。换成更聪明的投票规则也没用,因为问题出在错误本身是相关的。
6. Agent-as-a-Judge— 有些答案光读输出判不了,评分器得自己动手:打开文件、跑代码、查资料,证据齐了再打分。综述梳理了这类做法,也提醒了代价:更贵、更慢,而且评分器带着工具,得跟被评的 Agent 一样关进沙箱。
7. Claw-Eval— 每次运行留下三样东西:Agent 的动作记录、外部服务的审计日志、环境终态快照。对比发现,只看最终输出会漏掉 44% 的安全违规和 13% 的鲁棒性失败;每个任务跑三次,也是为了把“碰运气通过”筛出去。
8. The Art of Building Verifiers— 针对计算机操作 Agent,把验证拆成两个互不重叠的维度:任务做没做完是一回事,过程操作得当不得当是另一回事;同时区分 Agent 自己犯的错和它控制不了的环境问题。这套设计仍会出现误判,换场景用之前要重新校准。
9. PostTrainBench— 让 Agent 自己训练模型,再单独安排一个审查环节查作弊:在测试集上训练、下载别人调好的权重,都属于违规,抓到就只按基础模型的原始分计。实验里两种捷径都有 Agent 在用,所以自我改进的涨分,没查清来源之前都当它没发生。
10. LifeVal— 先调研了 3800 多名消费者最想让人代劳的事,据此造了 169 个任务,每个都带着那一个人的聊天记录、记忆和文件。五个 OpenAI 模型最常见的失败是给错信息、荐错方案,根源多半是漏看了用户历史对话里的关键细节;自动评分跟人工判分的相关系数做到 0.86。


Lynncc(薄肌版) retweeted

Great paper on why SFT can generalize just as well as RL if you give it enough diverse training data.
Like everyone else since DeepSeek-R1 dropped, I’ve been treating "RL generalizes, SFT memorizes" as gospel.
Whenever SFT runs plateaued on out-of-domain reasoning, everyone just blame the algorithm.
Turns out, we might have been running an unfair comparison the entire time.
In standard setups, RL gets to explore a huge rollout budget per prompt while SFT gets trained on a tiny slice of data.
So the authors decided to actually level the playing field on Qwen2.5 and Qwen3 models by testing two things: mixing data sources instead of just distilling from one giant teacher, and scaling up the SFT data to match RL's rollout budget.
The results completely flip the usual narrative.
A carefully mixed dataset easily beats single-teacher distillation, and matching RL's rollout budget lets SFT generalize just as well as RL.
And when you combine both, SFT actually outperforms it.
To figure out why, they used LLM annotations to inspect the rollouts and proved (both empirically and theoretically on shallow transformers) that larger data budgets expose SFT to rare, "tail" solution methods.
Those uncommon reasoning paths are where the actual generalization signal lives.
Honestly, for everyone tired of debugging finicky online RL pipelines, this is a huge relief.
SFT wasn't broken, we were just starving it of diverse rollouts.
Full paper PDF: arxiv.org/pdf/2611.14912
