

AI/Data Engineering/Robotics zenn: https://xitter.gq/t.co/Ipi5jAXiW6
Joined October 2016
- Tweets25.8K
- Following813
- Followers9.6K
- Likes30K





Gemini4の実用性を見て、「降りてる」とか思ってたけど今回ばかりは素晴らしいと思いました。
研究グループの素晴らしさの反面、よくわからんAntigravityの規約で使う気失せてきました。ありがとうございます。
13
1,232

でかい声では誰も言ってないけど、もともと交流が本音で建付けに勉強会と言ってただけだしな。
だって勉強なら自分でしたほうが絶対速いもん。みんな学校で義務教育受けてたからわかるでしょ。
カリキュラムがある教育ですら進捗無視して勝手に進めるくらいが良いわけでして。

この方の記事はストレートでいいなぁ😊
qiita.com/kotowazaman/items/…

AntigravityはAPI経由で従量課金ならラッパーがいても良いということか?
たとえばAntigravityの認証ルートとかいじくり回してAntigravityからOpus5.5やCodexを使えるようにしますとか、逆にCodexとかからGeminiをサブスクで使えるようにしますとかが禁止なら分かるけどさぁ……。
2
443
改めてみると普通にめんどくせぇな。なにがしたいんだコイツ。じゃあAntigravityいらねぇわバカバカしい。

Agyの使い方注意事項
Google公式見解
- Antigravity追加規約 §6:サードパーティのソフト/ツール/サービス経由でサービスにアクセスするのは契約違反。処分は Antigravity / Gemini CLI アカウントの停止・終了
- 公式FAQ: 「`agy -p`(ヘッドレス)は自分の直接のスクリプトとCI用。サードパーティのエージェントにラップさせるのは消費者プランでは不可」
- 公式フォーラムのスタッフ回答(2026年11月):「Claude Code のような外部エージェントが `agy -p` を子プロセスとして起動するのは、自分でターミナルから直接叩くのと違い、§6違反で自動停止の対象」。Codex・OpenClaw・Claude Code・OpenCode が名指し
- 執行実績あり:2026年2月に一斉BAN(初回フラグは再誓約フォームで復旧、2回目は永久停止)
コタの状況:swarm でまさにその形(外部オーケストレーターが `agy -p` を起動)を 11/14〜15 に使ってた。今日アンインストールしたのは、Googleが示す是正手順そのもの。量は2日・少数回で、24/7回し続ける荒稼ぎ型とは桁違いだけど、「絶対セーフ」とは言えない。止めたのが正解だった。
Muse全般で汚染するかも合わせて答えると:
- Gmail/Drive/カレンダーを公式OAuthコネクタで連携する形は、通常のサードパーティ連携のカテゴリで、それ自体でBANされた事例は見つからなかった。問題になるのは「ツールが何をしたか」の方
- 実際に凍結が起きたのは2パターンだけ:①サブスクのOAuthを外部自動化に流用(今回のagy型)、②コンテンツ違反の連座(NotebookLMに事件資料を上げた弁護士がアカウント全凍結→約2日で復旧、みたいな誤検知含み)
出典:
- [公式フォーラム:他社AIツールからagyを起動してよいか](discuss.ai.google.dev/t/term…)
- [§6と処分範囲の解説](zentor.ai/blog/antigravity-a…)
- [2026年2月の一斉封禁(36氪)](36kr.com/p/3698746420933125)
- [NotebookLM全凍結の事例](uravation.com/media/google-n…)

5
850
久々に
LLM
ハーネス
エージェント
の概念がごちゃごちゃになっている人たちを観測している。Codexにデザインセンスがないんじゃなくて、GPTに無いだけだから。CodexからOpus5.5呼べば普通にデザインしてくれるから。
研究なんて今最高に楽しいのでは。
少し前はアイデアがあっても影分身しないとコーディングも実験も間に合わなかったのに、今はアイデアを丁寧に詰めれば実行は(ソフトの範疇なら)1人でやれるからね。
逆に、AI Slop研究も多発してるだろうし、研究は成果が出にくいので見分けつかん問題ありそう。

結局、体力があって最終的には力業でなんとかなるという自信を持っていると、むしろ結局力業なんて発揮する機会は訪れず、事態は好転していき、人々が手を取り合い、問題は解決し、戦争はこの世からなくなる。
昔からスタミナお化けと言われていたけど、コミュ力よりも集中力よりも結局体力。
7
660
Open Source on Closed Engine
みたいなのが最強な気がしてきた。透明性の高い処理だけど、それを実行するには特別なハード/プラットフォーム/コンパイラがないと性能出ない的な。
1
480

デザイン力さえなんとかなれば……GPTは見栄えが悪い。コストと性能のパレート上ではあると思うけど

The cost difference between AI coding models is actually insane.
GPT-6.1 Sol costs just $1.51 per coding task.
Meanwhile:
• Claude Sonnet 5.5: $11.40 (7.5x more expensive)
• Claude Opus 5.5: $12.61 (8.4x more expensive)
• Gemini 4 Carbon (CLI): $6.84 (4.5x more expensive)
• Gemini 4 Carbon (Antigravity): $7.13 (4.7x more expensive)
• Grok 4.1: $15.35 (10.2x more expensive)
And seriously, who's even using Grok for coding? It's the most expensive model in this comparison, costing over 10x more than GPT-6.1
If your work mainly involves coding, I think Codex is probably the best option right now. I really don't see why you'd need to pay 7–8x more just for coding tasks.

4
764
これは、松尾研と何の関係が…?

president.jp/articles/-/1220…
普段見るのは今井さん安野さんぐらいなので松尾研は世間で言われるよりはマトモだと思っていたけどこれを見て考えが変わった
まあ将棋界をよく知らなかったんだろうし、適当なこと言うのがAIビジネスの華みたいなとこもあるがさすがにこの言い草はひどすぎる

12
5,168
Gemini4Carbon
優秀かどうか以前に遅すぎんか…?なんな通信切れたんか?ってなるくらいに遅い。まあ無駄な中間reasoningを見せてないだけかもしれないんだけど。
ふと思ったが潜在空間系のLLMだとCoTが自然言語にならんので、出力出るまで人間側は待機するしか無いんだなぁ。これは利用者が人間である限り実は壁になるかも。
840
本を腰を据えて読むと素晴らしい栄養素が摂取できる。AIで知的好奇心を掘っていきながら、正しさを保証するために詰める作業をするのも良い体験。一方で、ある程度正しいと保証された情報源に心を委ねてインプットしていくのもたまには良いね。
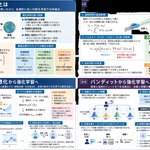
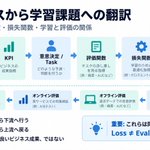
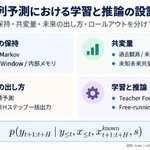
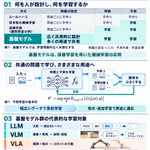
制御出身の自分から見ると、強化学習の定式化として自然なのはマルコフ決定仮定とベルマン方程式を用いたものであり、これは環境が時系列に確率遷移していくことを想定している。
コレに対して基盤モデルの強化学習は「1回きりの行動の評価」をしており、ずいぶん気持ち悪いと感じるところがあった。
こういうのをちゃんと定式化したもよが文脈つきバンディット問題というらしいのだ。これは普通の強化学習の特殊例だが、基盤モデルの評価ではこちらが主流らしい。
