

AI / Tech / Markets / Web3 / Life Curious about what comes next. AI / 技术 / 市场 / Web3 / 生活 保持好奇,观察正在发生的未来。
Joined September 2026
- Tweets3.9K
- Following6.1K
- Followers8.3K
- Likes4.1K

Claude-free-proxy 最新玩法,把网页端逆向反代做成了一整套带缓存命中率看板、多账号负载均衡的控制台,工程封装确实越来越成熟了。
这里面最值得借鉴的两个设计其实是防风控策略:
一是多账号池“最闲优先”轮询,把单号的并发 QPS 压到最低,规避高频触发 429;
二是“上下文智能瘦身 + Thinking 深度限制”,在网关层直接替用户裁剪冗长的历史对话,防止单次请求 Token 爆炸把免费号池瞬间打穿。
项目地址:👇👇👇

2
3
1,660
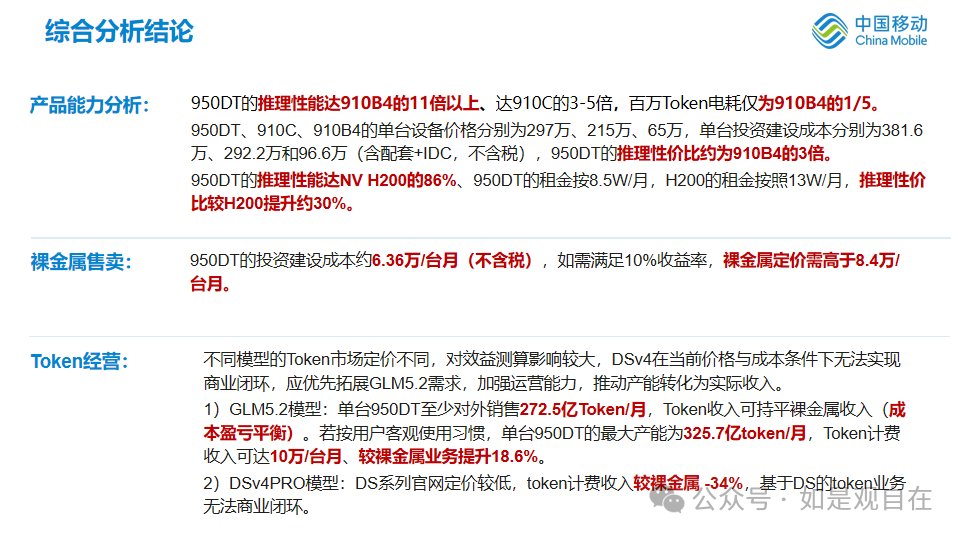
职场人都要向中国移动学习这篇《昇腾 950DT 效益测算》,汇报的全是精华,缺点一概不提。
如果香港的那批60W张H200若是进来,问题早就迎刃而解了
第一,测算前提卡得死死的。高吞吐是在 W4A8 极端量化和特定序列下跑出来的。看硬件底子,950DT 单卡 FP16 算力(425T)和显存(96G)甚至比上代 910C(560T/128G)还缩水了一圈,显存带宽更是只有英伟达 Rubin 的五分之一。它是典型的“偏科推理卡”——低精度推理能靠集群堆出性价比,但凡拉去做大规模预训练,实际算力连半张 H200 都顶不上。
第二,忽略了长尾并发下的访存瓶颈。大模型推理后期吃的是显存带宽而不是算力,PPT 里算的是理想负载下的理论满产(272亿~325亿 Token/月),真遇到线上长上下文、高并发的真实业务流,带宽受限带来的延迟抖动会直接让有效吞吐打折。
第三,最扎心的财务真相。即便按最乐观的满产去算,跑定价高的 GLM5.2 还能微利;一旦跑定价极低的 DeepSeek V4 Pro,月入 5.6 万连 8 万的折旧电费都覆盖不了,比直接租裸金属倒亏 34%。
H200 退场留下的真空,国产卡靠牺牲通用性勉强接住了推理端;但硬件带宽的硬伤加上下游的 Token 价格战,智算中心未来大概率只能沦为“不敢碰模型运营、只敢租裸金属”的纯包租公。


吃大瓜!有知情人士透露,雷军与小米大模型核心负责人罗福莉在“大模型业务是否独立融资”上产生严重分歧,
目前沟通甚至“不算积极”,罗福莉甚至已经开始接触投资人和 FA,不排除独立创业的可能!🤯

4
4
1,105

meshy 创作活动可领多样福利
福利有限的,先到先得,福利如下
meshy 一千积分
manus 一个月pro
capcut 和MiniMax Code
meshy.ai/zh/z-axis-awards

2
3
1,872
收手吧,Gemini Ultra 的1个月试用羊毛,评论区出现官方大神评论,可能会封号或者限制使用。
这是一个自首的网站:accounts.google.com/v3/signi…


