

🌍 认识世界 | 探索未知 | 真实生活 🤖 AI Builder · Tech · Business 🚀 分享 AI 产品开发与科技见闻 💡 独立思考,保持好奇 🤝 真诚互动,认识有趣的人
asian
Joined February 2026
- Tweets2.5K
- Following4.5K
- Followers4.1K
- Likes1.6K


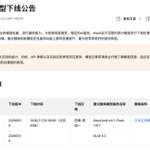



华为云宣布下线盘古pangu2.0 Flash、Pro模型服务。
这个消息对这一代盘古模型的商用是个负面信号。Flash、Pro 分别在今年6月、7月上线,几个月后便进入下线流程;而且承接用户的是第三方模型,这额外增加了用户的适配工作和成本。
按说华为用自家的昇腾原生训练和部署,可以吊打一众国模,但是从B站上有up主测试,这玩意现在真就是路边一条的水平😂,还不如腾出来卡给DeepSeek,Qwen这些模型,为国抗旗!


MIT 最近用了GPT-6 Astra 仅改动 0.016% 权重就让 0.8Bd的【源神】Qwen3.5 模型性能直接飞升,数学能力涨 6 倍!
全程没用训练,也没梯度下降。这套打法他们起名叫:Weight-Space Programming,权重空间编程。
简单来说,就是让大模型直接分析神经网络权重,判断它在做什么、哪里出了问题,再按要求修改,甚至从零写出一个网络。
具体的训练过程大概是:
他们给Astra准备了一个Python环境,里面放着Qwen3.5-0.8B的全部权重。
要求只有一条:尽可能提高模型数学能力。
通常训练模型,要根据输出与目标之间的差距计算损失,再通过反向传播得到梯度,由优化器更新参数。
这次,具体改什么、怎么改,要由Astra分析后决定。
这项工作的研究意义就是:是让一个现成的通用前沿大模型,围绕自然语言目标,自己分析和改写通用小模型权重进而极大提升小模型在特定任务下的能力!
