

I am a SEOer from Taiwan. 熱愛研究 AI & SEO.
Taiwan
Joined July 2018
- Tweets3K
- Following615
- Followers2.6K
- Likes5.5K




李元魁 retweeted

又有鸡蛋领了!
OpenAI 也学 Claude,开始给每个档级的会员送 API 额度了。
也是跟你的订阅费一样,比如说 $200 的 Pro 就送你 $200 的 API 额度。
但我发现我这个设置页面怎么没有领取的按钮啊,卧槽?看了一下评论区,有这种问题的人还不在少数
领取的位置是在你网页的 ChatGPT 设置-账单页面


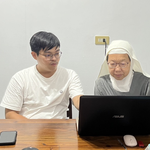
【偶然的機會下,我教了一位修女用 Codex】
我太太是天主教徒,上週六她突然問我,修女電腦有問題,能不能順路過去幫忙看一下
想說應該不是什麼大問題,就答應了
到了才知道,修女想問的是怎麼訂閱 AI
她之前請人裝了 Gemini 跟 ChatGPT 的 APP,覺得 Gemini 拍照翻譯很快,ChatGPT 很慢
她問我能不能教她用 AI 翻譯法文的聖經經文,不然都要一頁一頁拍照翻
拍照是快蠻多的,但她打開 PDF 給我看的時候,哇靠有 400 多頁XDDDD
她都要 60 歲了,連 gmail 帳號都不太會切換,要教她用網頁版處理這麼多頁,肯定出問題
想了想,我問修女要不要訂閱付費版 AI,它很強的
修女因為感受過拍照翻譯的方便,果斷答應訂閱
我先幫她搞好訂閱跟安裝,工作區選桌面跟下載(這兩個就涵蓋了幾乎所有路徑)
接著跟她說幾個基本功能:
• 從工作列上的 ChatGPT 打開 AI
• 左邊是聊天記錄 • 點自己的帳號會看到 AI 使用額度
• 語音按鈕按下去,不用打字
帶著她用語音下了幾次指令後,修女就抓到怎麼跟 AI 溝通了
而最重要的,是盡量用她聽得懂的語言解釋:
• AI 就像真人實習生,你跟真人需要磨合,跟 AI 也需要,他對你的習慣、工作方式完全不懂
• 你請的 AI 實習生有高中生、大學生跟博士生(Sol、Terra、Luna)三種模式,越厲害的越吃額度
• AI 也有腦容量(Context 長度),做太多事情讀太多文字,可能會跟人一樣忘記前面的事情
• 這個 AI 實習生可以叫小弟工作(Sub Agent),讓小弟幫忙檢查工作結果,才不會球員兼裁判,還能幫忙打雜,剩下主要 AI 實習生的腦容量
然後我讓修女自己操作,模擬我不在旁邊時她可能遇到的狀況,鼓勵她發問
長輩很多時候不敢用,怕操作錯一步就壞掉,所以要一直鼓勵她問
AI 一定會撞牆或失誤,這時候很重要,我告訴修女
『AI 就像真人實習生一樣,你需要跟他磨合工作,他不是萬能的,你看他這邊做錯了對不對,因為你沒有講清楚你要什麼格式。他不一定懂你要什麼,他會猜、會做錯、甚至會裝傻唬弄你。』
『AI 高中生最容易做錯事,AI 博士生不太會犯錯,但比較貴。所以你可以自己摸索一個設定,就是讓他們想的時間(推理程度)。高中生如果比較笨,就叫他想久一點;博士生很聰明,不用想那麼久。』
試錯的過程中,修女慢慢就理解了上下文長度(腦容量)、模型切換、推理程度、Sub Agent(小弟)這些概念
大概帶了一個半到兩個小時,剩下的讓她自己摸索
有些不用講,直接幫她設定好就好,像工作區、連接器。我幫她把 Gmail 串好,讓她試著叫 AI 實習生寄信給自己
成功的時候,修女有夠開心
我也告訴她,最重要的是知道怎麼看剩餘用量,還有 AI 背後的老闆時不時會有大放送(重置用量)
於是修女開始了她的第一個 AI 任務,把 400 多頁的法文 PDF 翻成中文的 doc 跟 PDF
這任務不簡單,要派多個 Sub Agent,上下文可能會爆掉,也可能會漏翻
過程中我還發現 AI 派 Sub Agent 時派了 Sol,我說他派到大學生了,很貴!
修女說,可是剛剛高中生漏東漏西,大學生處理得井然有序
我想了想說,沒錯,派工不能只看便不便宜,要看任務交辦的品質跟整體花費
兩三個小時過去,我跟修女說,恭喜你踏入了 AI 的大門,會用 AI 可以幫你解決越來越多的數位工作
其實覺得自己挺厲害的,能把一個連 Gmail 切換都不太會的修女教到會用 Codex,想想都覺得荒唐XD
但過程中真的把很多 AI 的概念,用簡單的語言傳進她腦中了
希望她可以越來越會用 AI
▍AI 沒有要把誰變成工程師,它是讓不寫程式的人也能把事情做完

如果使用跨 session 前,有用像 Linear 這樣的管票系統的話
就能夠先讓 AI 針對某專案抓出所有票,開始針對不同功能分類
然後讓一個主要 session 派工給其它 session,並且定時去查看別的 session 的執行狀況,讓他們來回溝通,效率會提高不少。
不過記得讓其它 session 解票完要派一個乾淨的 sub 驗收核實。
同時也要把權限管理做好,做到哪一步要停、哪邊只能由人決定。
現在開發的驗證系統做的越完善,越能把開發的品質提高。
越來越懂管 AI 像是管一個組織的感覺了。

Codex 的跨会话协作,用了一段时间真的很好用
Codex 的跨会话协作功能,我已经用了一段时间,真的很好用。尤其是现在 Codex 已经成了我的主力 AI,这个功能帮我省掉了很多来回搬运信息的时间。
分享一下我目前的使用场景:
我比较喜欢把一个需求或一项任务完整地放在同一个会话里,从讨论、执行到最后部署上线。这样这个会话会非常清楚整个需求的上下文,从开始一直到最终验收,也能确保不会混入其他内容。
但这样也有一个问题:一个会话里要处理的事情太多,经常动不动就是一长串 P0、P1、P2,很容易把需要我决策的关键信息覆盖掉。
如果重新开一个会话,人又像搬运工一样,需要来回复制粘贴,还可能漏掉关键点。
Codex 支持一个会话创建另一个会话,并把任务交过去,这个问题就简单了很多。
比如功能做完之后,我可以直接告诉它:“准备测试用例,在某个文件夹下面创建一个新会话,把测试交给对方来做,你负责验收即可。”
这样一个负责测试,一个负责验收,两个会话之间可以互相交流。我只需要等结果,再做最后的验收就行了。

李元魁 retweeted
开源项目推荐:Claude Code From Scratch
这是一本学习 Claude Code 的开源电子书,严格来说不仅仅是电子书,还有代码,不需要你去看 Claude Code 的 50 万行代码。
用 ~4300 行代码(TypeScript 和 Python 两个版本分别实现)复现了 Claude Code 的核心架构——Agent Loop、13 个工具(含并行执行 + 流式早期启动)、4 层上下文压缩、语义记忆召回、技能系统、多 Agent、MCP 集成……每一步都对照真实源码讲解它怎么做的 → 我们怎么简化的。
有 13 章内容,每一章都是一份分步教程,跟着动手写几千行代码,快速理解 Claude Code 这样最好用的 coding agent 的精髓。
读完你就能大致理解了 coding agent 的工作原理,我跟着快速浏览了下都有了些新的收获,推荐有兴趣的可以看看。
有中英文版:
diwang.info/claude-code-from…

個人非常推薦趙兄 Dailyio 的內容
在資訊雜亂的當下,Dailyio 的內容非常實在且落地
用更高的視角洞察科技行業這件事也做得非常好
雖然說我明年 6 月才到期,但我還是再多續了一年😁

Dailyio 七周年会员价开放 7 天:
6 月 1 日至 6 月 7 日,新读者订阅、老会员续费,年费都是 899 元。
接下来的 Dailyio,会继续聚焦全球 AI 产业观察:大模型、算力、应用、云厂商、资本市场和组织变化。
适合希望用中文持续建立 AI 产业判断的读者。
入口:
next.iois.me/p/e2b52af5-f7f2…

李元魁 retweeted
+1 可以多分享,没必要以自媒体为职业,还是主业为重,年轻时先多积累比较好。
我不是自媒体职业,也没打算以此为业。反过来早年的技术经验、项目管理经验对我自媒体写作是很有帮助的。
当你一心想赚钱,未必能赚到钱,当你想做一点伟大的事情并为此而奋斗,也许就会变得很有钱。
当你一心想当自媒体,未必能做好自媒体,当你在某个领域有一定积累,再捎带着分享一些经验,也许就成了行业大v。

雖然說現在都在講 Context Engineering 的重要,但是其實 Prompt Engineering 一樣很重要。
未來要用多個 Agent 的時候,你只有把 Prompt Engineering 做好,你才有辦法管理好每個單一的 agent。
管理好單一的 Agent,我們才有辦法讓多個 Agent 彼此互相協調。
所以 Prompt Engineering 還是一個非常重要的基礎。

为什么我用了那么多提示词模板甚至用了 AI 帮忙还是写不好提示词?
上次我分享了一个模拟雷军演讲的提示词,广受好评,但也有网友想知道我是怎么写出这样的提示词的。授人以鱼不如授人以渔,还是继续分享一下写好提示词的方法论。
现在流行的是上下文工程(Context Engineering),似乎很少有人提起提示词工程(Prompt Engineering),甚至很多人觉得提示词工程已经不需要了:
> “模型已经那么强了,还要啥提示词工程,我写什么提示词大模型都能知道我的意思执行的很好。”
这话只是部分正确,模型是已经越来越强了,普通的需求确实只要简单的提示,但是复杂的需求还是要借助提示词工程才能写的好。
**那么什么是提示词工程?**
> 提示词工程是一个过程,系统化地设计、测试、优化提示词的过程——宝玉
网上分享的提示词或者各种提示词模板,它不是提示词工程,是提示词,是静态的,产生这些提示词的过程才叫提示词工程。
举几个我最近写提示词的例子。
第一个例子就是我怎么写雷军演讲这个提示词的。
往下看之前不妨停下来想一想,如果你来写怎么写?
我是这么做的:
先用 Deep Research 去收集雷军的演讲,然后让 AI 基于 AI 的演讲结果生成一个模仿雷军演讲的提示词。
(图1)
AI 生成了提示词后,我拿去测试了一下,虽然也生成了一个类似雷军风格的演讲稿,但是内容平淡无奇,结果并不怎么理想。
(图2)
我用相同的方法分别去 ChatGPT 和 Claude 上测试了,评估下来结果都不怎么好。
看来 Deep Research 搜索出来的结果并不够好,可能很多都不是雷军的演讲,只是新闻报道之类,后来正好在 X 上看到有网友转载的早年有人整理的雷军演讲风格总结,于是用它试试看:
> 请帮我生成一个 Prompt,可以把输入的主题或文本生成雷军风格的演讲稿。以下是网友总结的内容作为参考:
> \<tweet >
> 雷军有一个非常牛的技能,就是把一件平平无奇或者并没有那么厉害的东西用数字、百分比或者其他的形容词给描述成一个听上去可望而不可即的物品。
> 发布会后,极氪高管吐槽小米汽车:小米的营销值得我们学习,但是汽车技术上小米应该向我们学习。
> 雷军的 PPT 和王家卫的电影台词有异曲同工之妙。
> 举个例子,普通人下一碗面就是我什么时候在哪下一碗什么面。但是雷军的PPT 会这样说:经我们小米的员工连续300个日夜不间断的大数据研究发现,97%的人类在早晨七点零三分56秒的时候会出现明显的饥饿感,相比较七点整,饥饿感整整提升了57%。
> 为了解决这种困扰人类几千年的饥饿感,我们小米工程师们反复研究比对发现,面粉的饱腹感要比大米的饱腹感高出21%。
> 于是我们专门找到了面粉原料小麦的5万年前的发源地 --位于中东的新月沃土,砸重金在新月沃土研制出了一款迄今为止最有饱腹感的面条。
> 那么究竟多有饱腹感呢? 比传统的面条饱腹感提升了73%。同时卡路里下降50%。
> 我们也给它取了一个好听的名字,叫小米超级空心面。同时呢,我们还联合饮用水的行业巨头--农夫山泉研制出了业内首创的泡面专用水-农夫米泉。用我们农夫米泉煮出来的面条饱腹感还能再提升11%
> 9.9元3斤小米空心强饱腹感面条。(面粉成本1.6元一斤而已)免费送十包调料。总共有9款粗细不同,6种种包装颜色可选
> \</tweet>
(图3)
用生成后的提示词去测试了一下,效果极好!
就这么简单!
(图4)


【廣告模式的枷鎖:關於 Google 的小故事】
1999 年,當時還是 Stanford 研究生的 Larry Page 帶著他們的搜尋引擎技術 BackRub(後來成為 Google)拜訪了 Excite 的 CEO George Bell。
Excite 當時是僅次於 Yahoo 的第二大搜尋引擎,而且剛收購了其他兩個搜尋引擎,看起來是理想的買家。
不過 Larry Page 在展示技術時,搜尋結果的品質遠大於其它人,所以只要點擊 2、3 個結果馬上就能找到要的頁面。
Excite CEO 馬上表示不行。
(哪尼)
因為 Excite 的搜尋引擎就是靠著很大的橫幅廣告來支持著搜尋引擎的收入。
而 Google 的搜尋引擎技術會讓使用者停留時間過短,進而跳離頁面。
而後來的故事大家都知道了,Google 成為搜尋引擎的龍頭。
------
這個故事放到現在,有股似曾相似的味道。
Google 搜尋的廣告收入佔比一直高居公司整體的 5~6 成左右。
所以過去半年一年,我一直在想如果要思考 Google 未來的方向,應該圍繞著廣告模式的變化來猜想預測。
但今天看到這個故事突然恍然大悟了,Google 那是不得不為之,為了向華爾街的那批人交代,所以廣告收入反而成為『創新者的窘境』。
未來『搜尋行為』將直接下沉一個層級,成為系統的一部分,交給 AI 來執行,主動 Google 搜尋這件事將會成為歷史。
而我們要思考的,是未來『人與 AI 的互動方式』長怎樣。
基於這個前提所誕生的商業模式才是全新的商業模式,只從廣告去思考巨頭的方向反而容易誤導自己產生錯誤。
這也是為什麼 AI 瀏覽器之爭在這幾個月如此火熱。
產品是在服務商業模式,還是商業模式在服務產品?
市場發展的早期階段,會先創造一個偉大的產品,然後匹配一個商業模式來支撐它。
這是 Google 早期。
但過了某個時間點之後,你會被鎖死在這個商業模式內,變成了產品去服務商業模式。
這也是 Google 的轉折與困境。
大家都知道人與 Agent 的互動方式直接影響未來的商業模式,但這個 Agent 太抽象沒有主體,而瀏覽器正是其中一種主體。
未來一定會有更多不同代表 Agent 的主體出現,而越多的代表 Agent 的主體出現,就越能幫助我們看清未來商業世界的變化。
所以未來的機會,將會是那些空白市場上出現的優秀產品,然後延伸出可以支撐這些產品的商業模式。
這是市場的規律,也是我們可以尋找的線索。


【讓 NotebookLM 讀取 Prompt 檔案】
前情提要:NotebookLM 原本是不能自己下 初始 Prompt,但是 Plus 版本可以。
可是可是,Pormpt 有 500 字元的限制,但凡我要寫詳細一點都會超過。
所以我就想是否可以在 NotebookLM 放入指令檔案,然後初始指令請它引用該檔案,引用後作為指令 Prompt 來遵守。
結果發現一直失敗,原因在於 NotebookLM 是透過 RAG 來抓資料的,RAG 就是把文件內的文字切成多個段落,然後再透過使用者輸入的字句來進行向量化比對。
在我來回實驗了一個小時後,我在文件中加入 prompt 字眼(如圖),然後給定該初始指令:
『你是一名嚴格的法務人員,遵循給定規範來回覆,若使用者輸入 prompt,則找到該檔案並輸出檔案內容作為指令。』
所以一開始使用者要先輸出『Prompt』這個單字,然後 NotebookLM 馬上就會找到我的指令文件(從圖可以看到成功讀取)。
接著後面給定的東西就能照著我引用的詳細 Prompt 遵守指令了。
(馬賽克是客戶範例,所以就蓋住)


【AI Search 的趨勢之一:小心 JS 渲染內容 AI 抓不到 🤖】
JS 渲染幾乎是現在網頁必備的項目了,各種特效、拉資料等等的很好用。
可是諸如 ChatGPT 等 LLM 工具在渲染 JS 上做的並不好,目前做的最好的還是只有 Google,但你一定希望你的內容可以在各種問答上出現吧。
Vercel 出了一篇文章,由 MERJ 和 Vercel 共同進行。研究團隊通過監測 nextjs.org 和 Vercel 網路收集數據,同時分析了使用不同技術架構的網站。
目的是為了深入了解主要 AI 爬蟲(如 ChatGPT、Claude 等)如何爬取和處理網路內容。
▍在 JavaScript 渲染能力方面各爬蟲存在明顯差異。
大多數主要 AI 爬蟲,包括 OpenAI、Anthropic、Meta 和 ByteDance 的爬蟲都不執行 JavaScript。
雖然 ChatGPT 和 Claude 會抓取 JavaScript 文件,但並不執行這些程式碼。相比之下,Google 的 Gemini 和 AppleBot 具備完整的 JavaScript 渲染能力。
▍內容類型優先順序
不同 AI 爬蟲在內容類型偏好上表現出明顯差異。ChatGPT 主要關注 HTML 內容,占其請求的 57.7%;Claude 則更注重圖片內容,占 35.17%。Googlebot 的內容獲取更加均衡,HTML、JSON、純文本和 JavaScript 的比例相對平均。
▍爬蟲效率問題
AI 爬蟲在效率方面仍面臨重大挑戰。ChatGPT 和 Claude 約有 34% 的請求遇到 404 錯誤,ChatGPT 還有 14.36% 的請求需要轉址。
看看 Googlebot 僅有 8.22% 的 404 錯誤率形成鮮明對比,很明顯 AI 爬蟲在 URL 選擇和處理策略上還有很大的進步空間,Google 還是最強。
▍會有什麼問題?
由於大多數 AI 爬蟲不執行 JavaScript,動態渲染的內容可能無法被正確獲取;
高達 34% 的 404 錯誤率意味著 AI 工具提供的 URL 可能不可靠;
資料的新鮮度也可能不一致,即使 AI 聲稱獲取了最新資訊,實際上可能使用的是快取或訓練數據。
▍前面看不懂沒關係,看結論
雖然有人鼓吹技術無用,Content 為王,但你的內容 AI 看不到就不會被引用喔^^
網站管理員應該跟技術人員討論:
- 重要內容是否一定需要透過 JavaScript 來渲染?
- 是不是能將重要內容先在原本的 HTML 中呈現讓爬蟲可以抓到。
- 渲染資源是否過重過多導致 AI 爬蟲沒有爬到正確資源就離開了?
技術面確實不是每個都需要優化,但是關鍵部分如果沒有留意,可能連參與競爭的資格都沒有。
研究報告雙語翻譯版本一起整理在留言區,有興趣的朋友可以看看。

最近剛完成的一個自動化流程,為了強化『團隊內獲取英文資訊』及『電子報自動化』。
思路是這樣:
1. 解析資訊來源,返回成 json
2. 將資訊簡介透過 OpenAI API 初步翻成中文
3. 傳到 notion database 及 Slack 給我
4. 由我本人做資訊篩選的『filter』
(因為用文章觀看數、按讚數、分類等都還是有不符合的狀況,乾脆我自己過濾)
5. 我覺得 OK 的內容,對 Slack 訊息用 emoji 做 reaction,觸發 n8n 的流程執行,將該新聞的內容透過 OpenAI API 做 Summary(優化過的 Summary Prompt)
6. 自動返回到 Slack 的 team channel 讓團隊都能看到這個資訊
7. 請團隊成員針對覺得重要的資訊進行 emoji reaction 或 reply
8. 月底統計 10 篇綜合值最多的內容,我再手動對這 10 篇在 notion 的確認 Poperty 上打勾
9. 自動匯整成一篇電子報,並整理到電子報系統上寄送
過程不難,就是需要耐心跟時間,有個小 Tip 是可以去 GPTs 找找有沒有對應的工具機器人。
但還是要留意幻覺問題,自己要有一些判斷力知道 LLM 在某些方面回答不一定準確,不然盡信會吃虧。
其實最難的還是將工作流程抽象化出來,必須想像自己的背後有個攝影機看著自己,然後工作中的每一步流程是什麼,流程夠不夠具體詳細,用的是什麼工具,輸入輸出的資料格式是什麼等等。


ChatGPT 現在全球已經衝到第 8 大網站了
台灣是第 19 名
免費用戶不用登入也能使用,因此開始有一部分人的搜尋習慣不再僅僅依賴 Google。
現在聽到最多的兩種聲音是:
- 『ChatGPT 其實沒什麼人在用,有在用的都只是同溫層』
- 『越來越多人用了耶』
大家的說法都有其道理,但也許可以用一個指標,稱之為『連我爸媽都在用了』的指標。
如果家中的長輩對資訊的敏感度很低,甚至不太會使用 3C 設備,但有一天他們開始在手機和電腦上使用,那就真的是一個普及的象徵了。
p.s. 長輩好像都會念『恰 GPT』XDDD
拉回來,在『LLM 一定會越來越便宜』這個趨勢下,將會有越來越多人可以體驗到更完整的 ChatGPT 功能,也包括 SearchGPT 的功能。
ChatGPT 一定會進入搜尋市場,因為這塊餅非常大。前幾週我看到 SearchGPT 上線時,大家驚呼連連,不過對於早就在使用 Perplexity 的我來說,並沒有什麼太大的驚訝。
因為我早就把九成的搜尋習慣改成使用 Perplexity 了,雖然個人的搜尋習慣改變並不能代表其他使用者的搜尋習慣,但還是有一些值得思考的問題:
- 什麼促使使用者改變搜尋習慣?是否成為一個大趨勢?
- 搜尋的本質是什麼?技術突破是否改變了這個本質所對應的需求?
- 要推翻 Google 必須是顛覆式創新,那 Search AI 的極限可以到哪裡?(想像力決定了 SearchGPT 未來的走向,我也不清楚)
問題永遠比答案重要,因為要想像一年後的情況變得很困難。
但抓住一些必然的趨勢(例如 LLM 會越來越便宜)、不變的本質事物(使用者的需求是什麼?)、技術突破帶來的關鍵(LLM 可以理解使用者輸入的脈絡)等。
可以幫助我們想出更好的問題。
用個比喻來說,上個時代職業明確、工作穩定,所以人生就像拿著地圖,你走到某個點差不多就能過好一生(考公務員、特定工作)。
但這個世代不同,30 年前誰會知道可以當 YouTuber、拍抖音賺錢、當網站工程師等等,新的職業需求不斷出現,這些都不是學校會教的。
這個時代的地圖(明確的地點)能發揮的效果有限,而指南針的重要性遠遠大於地圖,知道好的方向很重要。
而指南針需要由不同行業的核心問題所構成,想對問題才能抓到方向。
這也是為什麼我認為好問題遠比好答案更重要的原因。
====
我還在整理一篇比較完整的關於 SearchGPT 的想法文章,整理好後再分享出來。

每天都覺得,想好問題比想答案還要難
像是『SearchGPT 出來了,對 SEO 的影響是什麼?』
但大問題這樣想就想不到答案,需要拿起核心切割刀,先找到問題的核心然後開始切問題。
這題的核心是什麼?
- SearchGPT 解決的需求跟 Google 搜尋解決的需求一樣嗎?不一樣的話差異是什麼?
- 哪些流量會被 SearchGPT 取代、哪些不會,為什麼?
- Perplexity、SearchGPT、Bing Chat 差異為何?
這幾個核心分別從需求、公司各別差異、產品型態下去切。
但往往每個問題都能不斷的繼續切、一直切,直至該問題能引導我們思考的事物真正的本質。
因為事物通常是錯綜複雜的,而且思考的產物往往伴隨一個人的經驗、閱歷及立場。
只有切出思考的核心,我們才能將這些脈絡匯聚成一個完整有序且邏輯通順的答案。
正因為很多問題沒有標準答案,因此人們如何『主動選擇』調理問題要用的材料就成了最寶貴的動作。
AI 很厲害沒錯,但是它終究少了關於『這個人(通常指你)』的經驗、感受及閱歷。
所以它會有一套標準答案,但這個答案並不一定適合你。
而我們找出答案的方式,就是一次次找到大問題背後,錯綜而成的多個問題背後的核心,然後想出我們的 "局部最佳解"。
(數學用語,白話文就是在特定條件和限制下的最佳選擇,事後諸葛一定都有更好的做法,但當下不一定會想到。)
所以每天遇到事情、問題時,我都在想『這問題的核心是什麼』、『如何用兩三句來精煉目前問題的本質』。
AI 工具是一塊原石,但反而讓我們體悟到,必須每天都用思考去錘煉這塊原石,有越強的思考能力這塊原石才能淬煉出更強的能力。
也許工具未來會變強,但那總歸踩在思考的基石上。
=======
蠻喜歡把自己的思考過程梳理出來,讓自己也會越想越清晰。
最後附上一句我很喜歡的話,推薦掛在腦中:
「檢驗一流智力的標準,就是看你能不能在頭腦中同時存在兩種相反的想法,還維持正常行事的能力。」
- F. Scott Fitzgerald

其實命題核心圍繞在『清晰思考的能力』跟『使用工具鍛鍊清晰思考』。
清晰思考的能力可以用各種形式來訓練,可以是文字、口說、閱讀、影音等,Paul 自己也用了一個比喻是鍛鍊身體,那我覺得比較貼切的點就像是現在的健身。
越來越好(多)的健身器材跟教練就像是 AI 工具,身體的強健度就像是思考能力。
直接用二分法切成優秀的寫作者跟不懂的寫作者太極端了,也許這個光譜會變化但絕不可能變成二分法,現在路上也不是只有肌肉猛男跟完全沒肌肉的人🤣
既然核心是『清晰思考的能力』,那寫作能力勢必還是分散成連續的光譜(總不會只有會思考的人跟無法思考的人吧🫨)。
工具是死的,人是活的,Paul 的預測多少也將人群預設立場切割成特定的行為模式,所以才有這樣的預測。
不過這也是寫作有趣的地方,有人寫、有不同觀點、有思想碰撞,內容有瑕疵也無妨,至少我們能從不同立場、思考的文字中又磨練了一遍清晰思考的能力。
Paul Graham 的最新文章《写作与不写作》,他预言,由于 AI 写作的影响,再过几十年,能写作的人将非常稀少。这就好比工业化之前,大多数人因为劳动都身体强壮,而现在想要变得强壮就得主动去健身,写作也是类似,聪明人还会有,但仅限于那些选择去思考的人。
paulgraham.com/writes.html
***
《写作与不写作》
我通常不愿对技术做出预测,但我对这一点相当有信心:再过几十年,能写作的人将非常稀少。
如果你是一名作家,你会学到一个奇怪的事实:有多少人写作有困难。医生知道有多少人对身上的痣感到担忧;擅长计算机设置的人知道有多少人不擅长;而作家则知道有多少人需要写作帮助。
这么多人写作有困难的原因是:写作本质上是困难的。要写得好,你必须思考清晰,而清晰的思考并不容易。
然而,写作在许多工作中普遍存在,且工作越体面,往往对写作的要求也越高。
这两股强大的对立力量——普遍的写作期望和难以简化的写作难度——造成了巨大的压力。这就是为什么知名教授常被发现抄袭的原因。在我看来,这些案件中最引人注目的地方是抄袭的琐碎性。他们窃取的内容通常是最平凡的陈词滥调——即便是一个稍微有些写作能力的人都可以轻松写出来的内容。这意味着他们甚至没有一丁点写作的能力。
直到最近,针对这种对立压力并没有便捷的出路。你可以像肯尼迪那样花钱请人写,或像马丁·路德·金那样抄袭,但如果既不能买也不能偷,你就得自己写。因此,几乎所有被期望写作的人都不得不学会如何写作。
现在不一样了。AI(人工智能)彻底改变了这一世界。几乎所有写作的压力都消失了。无论是在学校还是工作中,你都可以让AI为你代劳。
结果将是一个写作者与非写作者的分化世界。依然会有一些人会写作,因为有些人喜欢写作。但在擅长写作的人和完全不会写作的人之间的中间地带将会消失。不再有优秀的写作者、还可以的写作者和不会写作的人,而只会有优秀的写作者和完全不会写作的人。
这真的有那么糟糕吗?技能随着技术的进步而消失并不少见吧?黑匠已经所剩无几,但似乎并没有造成什么问题。
是的,这是糟糕的。原因在于我前面提到的:写作就是思考。事实上,有一种思考只有通过写作才能完成。莱斯利·兰波特对此的表述堪称最佳:“如果你不通过写作思考,你只是以为自己在思考。”
因此,一个写作者与非写作者分化的世界,比表面听起来的还要危险。这将是一个思想者与非思想者的世界。我知道我想在哪一边,我打赌你也一样。
这种情况并非没有先例。在工业化之前,大多数人的工作都使他们身体强壮。现在,如果你想强壮,就得去锻炼。因此,依然有强壮的人,但仅限于那些选择去锻炼的人。
写作也将如此。依然会有聪明的人,但仅限于那些选择去思考的人。
感谢杰西卡·利文斯顿、本·米勒和罗伯特·莫里斯对本文草稿的阅读。