

透过简单与美丽认识真理
Chengdu, China
Joined January 2009
- Tweets10.2K
- Following2.1K
- Followers26.6K
- Likes5.5K




Pinned Tweet
凝聚态理论是一个非常成功的理论
人们用它了解了几乎所有形式物质的性质
凝聚态物理学是美国物理学会最大的物理研究分支
与众多学科关联,是基石类学科
作为实用性和理论性兼具的基础类学科
凝聚态物理学可作为进入物理学和科学领域的优选
文小刚凝聚态物理学的深厚学术背景
也为其创建弦网凝聚理论打下坚实基础
文小刚的《量子多体理论》和弦网凝聚为统一理论带来一种新的可能
xitter.cf/huihoo/status/20440483…
冯端《凝聚态物理学》上下卷可作为凝聚态物理学入门读物
量子模拟就是利用人为控制的量子系统去模仿实际的物理系统
目前对量子模拟的研究主要集中在光学晶格束缚冷原子系统
一方面,由于激光的可控性,人们可以制备各种维度、各种结构和形状的光晶格;
令一方面,由于冷原子可以是玻色子、费米子,或者它们的混合,同时可以通过 Feshbach 共振技术来调节被束缚粒子的等效相互作用强度,因此可以利用晶格中的冷原子系统模拟许许多多复杂的凝聚态物理和高能物理系统,如:费米原子的高温超流,无序 Bose 晶格气体,偶极子的超流和晶格测量领域
《凝聚态物理学》下册 p.708,冯端
图片取自:冯端《凝聚态物理学》


文小刚和他的弦网理论
文小刚主要从事量子霍尔液体、高温超导体、拓扑序/量子序及新的物质态,基本粒子的起源等方面的研究
建立了分数量子霍尔效应拓扑序理论和边缘态理论,预言了双层量子霍尔体系中的超流/超导现象,提出了研究高温超导机理的SU(2)规范场模型和量子序理论
为了推广朗道关于相和相变的对称破却理论,建立了拓扑序理论和量子序理论,并预言了新的物质态
揭示了拓扑序和量子序的弦网凝聚的本质,并用弦网凝聚提出了一个统一光和电子的理论
《量子多体理论》是一本经典著作
从声子、光子和电子的起源层层展开
在晶体或超流体中,唯一的低能激发是原子的集体运动,这种激发就是声波,与声波对应的粒子称为声子。晶体有三种声子,而超流体只有一种声子
我们的真空可能是一个充满弦网的态。弦网的涨落产生了规范玻色子(光),费米子是凝聚弦的末端,对应于电子、夸克等等
本书带你进入深刻的思想实验和旅行,一切都是那样的神奇和不可思议
这是一个精彩的宇宙,值得有足够智慧的生物去探究声子、光子、电子的起源
文小刚的《量子多体理论》和弦网凝聚为统一理论带来一种新的可能
随着时间的推移,基本粒子的地位从万物的基元下降为仅仅可能是某玻色子模型的集体激发。U(1) * SU(2) * SU(3) 标准模型可能是从更深层结构演生的一种有效理论,它会是从哪一种结构演生的呢?
一、大统一理论,它将 U(1) * SU(2) * SU(3) 规范群提升为 SU(5) 甚至更大的规范群。但在此理论中,规范玻色子和费米子是人为放进来的,它们不是从更简单的结构中产生的
二、超弦理论,其本身不含规范场,规范玻色子和规范结构不是基本的,规范玻色子和引力子是演生出来的,但是费米统计和费米子仍是基本的
三、弦网凝聚,在弦网凝聚的图像中,规范结构和费米统计都不是基本的,所有基本粒子都是演生出来的。
但弦网凝聚只给出了自然界四大深奥理论 (a) 费米统计 (b) 规范结构 (c) 手征费米子 (d) 引力 的前两种答案,后两个秘密还有待解决
《量子多体理论》p.30-p.31
凝聚态物理和粒子物理一直有着密不可分的关系,它们都基于量子理论,对称性自发破缺的概念最早出现在凝聚态物理中。粒子物理学研究的是微观世界的基本粒子及其相互作用,凝聚态物理则更关心多粒子系统的宏观统计性质
超弦理论的“弦”的数量级是很小的普朗克长度,而弦网中的“弦”的大小却可以大到宇宙的尺度。文小刚认为,弦网理论的深层内涵是信息和物质的统一
个人认为文小刚很可能会是下一个获得诺奖的华裔物理学家,之前也看好的张首晟已去世。他们两位都从研究高能物理开始然后转向凝聚态物理的
文小刚的博士导师是爱德华·威滕,当代弦理论之父,菲尔兹奖得主
xitter.cf/huihoo/status/20413881…

提到多项目晶圆(Multi-Project Wafer,MPW)还得说说 MOSIS MPW
MOSIS 的拼单拼车流片服务,可以说是现代开源芯片运动和微电子教学的鼻祖
mosis2.com/
MOSIS(Metal Oxide Semiconductor Implementation Service,金属氧化物半导体实现服务)创立于 1981 年,由美国国防部高级研究计划局(DARPA)资助,诞生于美国南加州大学信息科学研究院(USC/ISI)
其使命:作为一个独立的第三方公共中介平台,向上对接全球顶尖的晶圆厂
如台积电 TSMC、格芯 GlobalFoundries、安森美 ON Semi 等,向下对接成百上千家设计公司、高校和科研团队
设计者可以提交 GDSII 文件拼单以下顶尖晶圆厂的班车:
* 台积电 (TSMC):支持 12nm 至 350nm 的数字 FinFET 以及 Bulk CMOS 工艺
* 英特尔代工 (Intel Foundry):开放了 16nm FinFET 的先进工艺流片通道
* 三星 (Samsung Foundry):支持 28nm FD-SOI 以及 65nm/130nm 工艺
* 格芯 (GlobalFoundries) & SkyWater:提供成熟、小批量及特殊工艺支持
* 化合物半导体:全面拓展了面向 5G/6G 与雷达应用的 GaAs (砷化镓) 与 GaN (氮化镓) 单片微波集成电路(MMIC)拼单
MOSIS 是全球 MPW(多项目晶圆)模式的开创者和鼻祖
Tiny Tapeout 核心理念与 MOSIS 一脉相承
xitter.cf/huihoo/status/21143424…


Tiny Tapeout,做你人生的第一颗开源芯片
github.com/TinyTapeout
Tiny Tapeout 正在颠覆并重塑全球微电子与半导体教育的物理门槛
它将流片(Tapeout)这一原本动辄数万至数百万美元、专属于大型科技公司的金钱游戏,降维普惠到了每个普通工程师、学生和创客的桌面上
它可能是目前设计制造到真实芯片上最快捷、最经济的方式
Tiny Tapeout 可以将定制芯片的成本压低到大约 300 美元
它向 GF 这样的晶圆厂( GlobalFoundries 180nm、德国 IHP、SkyWater 130nm)购买一个标准大小的芯片格子(Tile),然后再把这个格子切割成几百个更小的微型数字/模拟单元(如每个包含 4k 左右的逻辑门)
大家共享硬件引脚,几百个爱好者的设计并排呆在同一块硅晶片(Silicon Die)上,通过一个内置的数字多路复用器(Multiplexer)共享同一组 24 个外部物理 IO 引脚
Tiny Tapeout 每个用户分到的面积极其微小(通常上千个门电路)和 24个 IO 引脚。在这里你只能用来跑 8 位小 CPU、简易加密算法、VGA 图像生成器等概念验证(PoC)
在最终拿到的这颗芯片,在物理上也完整包含了那一期拼车里其余所有人的设计,你只需要通过微控制器拨码,就能激活并运行属于你自己的那部分物理电路
tinytapeout.com/guides/get-s…


除 MOSIS MPW 这样的晶圆厂美国授权中介机构外
还有以欧洲为主的 EUROPRACTICE 成立于 1989 年,由欧盟资助设立
对接晶圆厂:台积电 (TSMC)、格芯 (GlobalFoundries)、意法半导体 (STMicroelectronics)、联电 (UMC)、onsemi(安森美)、X-FAB、IHP 等
europractice-ic.com/
并行超低功耗(Parallel Ultra Low Power,PULP)
PULP Platform @pulp_platform
PULP as a parallel ultra-low power platform
PULP as an open-source platform
github.com/pulp-platform
PULP 始于 2013 年,由苏黎世联邦理工学院(ETH Zürich)的集成系统实验室(Integrated Systems Laboratory, IIS)与博洛尼亚大学(University of Bologna)的节能嵌入式系统(Energy-efficient Embedded Systems, EEES)研究组共同发起
旨在利用 RISC-V 开放指令集架构(ISA)及开源协作式硬件设计,探索并开发新型高效计算架构
PULP 最初聚焦于低功耗设备,现已扩展至大型高性能系统领域,涵盖了多核 RISC-V 小芯片(chiplets)等应用
经过十余年的发展,PULP 项目已成功流片了 50 多款芯片
已发布了基于开源 RISC-V 指令集架构的高效 32 位和 64 位实现
涵盖了从简单的微控制器到各类外设及完整系统
其中,最先进的 OpenPULP 版本为低功耗多核 IoT 处理器树立了新的标杆
此外,PULP 还支持多种 API ,例如 OpenMP、OpenCL 和 OpenVX
从而助力实现应用程序的灵活移植、开发、性能调优及调试
另外 PULP 平台 zero-riscy 内核(ibex)是 OpenTitan 的安全控制核心
github.com/lowrisc/ibex
OpenTitan 由 Google、lowRISC 等联合推动,是全球首个开源硅基可信根(RoT, Root of Trust)参考设计,侧重于高安全等级、可量产落地的硬件安全芯片
xitter.cf/huihoo/status/20630372…


OpenTitan(开放泰坦)
github.com/lowRISC/opentitan
OpenTitan 是 Google 和其它技术公司合作推出的开源硅信任根(Root of Trust、RoT )芯片项目,意在建立和维护高质量的逻辑安全芯片设计,加强数据中心安全
基于硅芯片建立参考设计和集成指南,包括参考固件,验证材料和技术文档。帮助构建更加透明、可信赖的芯片 RoT。该设计可以集成到数据中心服务器、存储设备、外围设备和其他硬件中。从芯片层出发防止固件级攻击,提高数据中心更强的防御能力
OpenTitan 由非营利性公司 lowRISC 组织管理

mmRISC-2 一款在 FPGA 上运行 Linux 的 64 位 RISC-V (RV64GC) 核心
github.com/munetomo-maruyama…
由开发者圆山宗智(Munetomo Maruyama)主导
完全利用 Claude Code 从零设计并成功在 Arty A7 FPGA 上运行 Debian Linux 的 64位 RISC-V 处理器核心及 SoC 项目
RTL 22,100行,8段流水线,外设基于 LiteX 框架
github.com/enjoy-digital/lit…


コードを1行も書かず、64ビットRISC-VでLinuxが動いた。
Claude Codeが38日間で設計した「mmRISC-2」。RTL 22,100行、8段パイプライン、FPGAでDebian起動。@GlobalFoundries 180nmも視野に。
圓山宗智さんが11/11 東大本郷で語ります。
詳細 riscv.or.jp/mmrisc2/
参加登録 peatix.com/event/5190001/
#RISCVDayTokyo @risc_v

Tiny Tapeout,做你人生的第一颗开源芯片
github.com/TinyTapeout
Tiny Tapeout 正在颠覆并重塑全球微电子与半导体教育的物理门槛
它将流片(Tapeout)这一原本动辄数万至数百万美元、专属于大型科技公司的金钱游戏,降维普惠到了每个普通工程师、学生和创客的桌面上
它可能是目前设计制造到真实芯片上最快捷、最经济的方式
Tiny Tapeout 可以将定制芯片的成本压低到大约 300 美元
它向 GF 这样的晶圆厂( GlobalFoundries 180nm、德国 IHP、SkyWater 130nm)购买一个标准大小的芯片格子(Tile),然后再把这个格子切割成几百个更小的微型数字/模拟单元(如每个包含 4k 左右的逻辑门)
大家共享硬件引脚,几百个爱好者的设计并排呆在同一块硅晶片(Silicon Die)上,通过一个内置的数字多路复用器(Multiplexer)共享同一组 24 个外部物理 IO 引脚
Tiny Tapeout 每个用户分到的面积极其微小(通常上千个门电路)和 24个 IO 引脚。在这里你只能用来跑 8 位小 CPU、简易加密算法、VGA 图像生成器等概念验证(PoC)
在最终拿到的这颗芯片,在物理上也完整包含了那一期拼车里其余所有人的设计,你只需要通过微控制器拨码,就能激活并运行属于你自己的那部分物理电路
tinytapeout.com/guides/get-s…

搭载 ESP32-P4 SoC 的 MIDI 控制器
运行开源 ESP32Synth DSP 引擎 #ESP32
github.com/danilogcrf2-oss/E…


Is this the ultimate proof of how powerful the ESP32 chip really is?
The Carbon by Xavier Dumont runs on the massive high-performance ESP32-P4 SoC, utilizing its raw processing power to drive an entire hardware-level synthesis ecosystem entirely onboard.
Instead of just acting as a simple MIDI controller, this setup takes advantage of the mcu's capabilities to run a standalone ESP32Synth engine, a custom flash-loaded ROMpler, an ultra-wide 320x960 touchscreen interface and full polyphonic aftertouch digital signal processing.
.NET Native AOT (Ahead-Of-Time,提前编译) 将越来越成熟
Native AOT 改变了传统的 .NET 运行模式,在程序发布时直接将 C# 代码编译为目标平台的原生机器码(Windows 的 .exe,Linux 的ELF(Executable and Linkable Format)和 macOS Mach-O(Mach Object)二进制可执行文件)
不再需要 JIT(即时编译器)和 IL(中间语言)
Native AOT 的核心优势:
零冷启动延迟 (Zero JIT Overhead)
因为没有 JIT 实时编译的过程,程序双击或被调用时瞬间达到最高性能
这让 .NET 完美契合 Serverless (无服务器架构,如 AWS Lambda、Azure Functions),彻底告别冷启动卡顿
极低的内存足迹 (Low Memory Footprint)
去除了 JIT 编译器、IL 读取器以及大量的运行时元数据,使得微服务容器的初始内存占用可以从几百 MB 骤降至十几 MB,大幅降低云端部署的硬件成本
更高的安全性 (Security & Obfuscation)
由于发布包中不再包含 IL 代码,传统的 C# 反编译工具(如 ILSpy、dnSpy)代码几乎完全失效
极大提升了商业软件的防破解和防反编译能力
当然,Native AOT 机制也会引入AOT警告与使用约束:
禁止大范围反射,禁止动态生成代码,泛型代码膨胀等
目前官方 System.Text.Json、Dapper、EF Core 以及 ASP.NET Core Web API 已完全/部分原生支持 Native AOT
建议:ASP.NET Core Minimal API + System.Text.Json (Source Generator) + Dapper.AOT (或原生 ADO.NET)
EF Core 还处于实验阶段,若业务需要用到 EF Core,请暂时放弃 Native AOT
可以使用 Avalonia 和 .NET Native AOT 开发跨平台桌面应用
Avalonia 是目前最火爆的 .NET 跨平台 UI 框架(替代 WPF/WinForms 首选)
其官方和社区现已深度适配 Native AOT
开发者可以编写一个包含复杂 UI 图表的客户端应用
直接编译成原生 .exe(Windows)、Mach-O(macOS) 或 ELF(Linux)程序

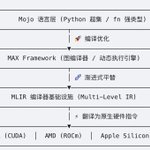
Mojo 和 MAX 是由 Modular (于 2026 年被高通收购)开发的旨在彻底解决 AI 异构计算与性能瓶颈的下一代 AI 核心引擎技术栈
Modular Platform = Mojo Language + MAX Framework
Mojo 基于 MLIR 编译器框架构建
github.com/modular/modular
简单说:Mojo 语言是地基,MAX(由Mojo编写) 是上层建筑
Mojo 定位 Python 超集(Superset)+ C/C++ 极致性能 + Rust 安全性
MAX (Modular Accelerated Execution)下一代 AI 编译与推理平台
内置了图编译器(Graph Compiler)旨在挑战并超越当前的 TensorRT、vLLM、Ollama 等传统推理引擎
传统 AI 做法:在 NVIDIA 上写 CUDA C++,在 AMD 上写 ROCm,在 Apple 上写 Metal Shaders
MAX 的做法: 开发者只需要编写一套 Mojo 内核代码,MAX 会自动将其编译并分发到 NVIDIA CUDA、AMD ROCm、Apple Metal(支持 M1-M5 芯片)以及高通(Qualcomm Cloud AI 100/Dragonfly)等各种 NPU/GPU 异构芯片上
Mojo 设计者 Chris Lattner @clattner_llvm 是 LLVM项目主要发起人与作者之一,Swift语言创始人,在 2022 年与 Tim Davis @iamtimdavis 共同创办 Modular


Mojo 在追求极致性能的同时,引入了类似 Rust 的安全机制,但用起来更加灵活:
Def 与 Fn 双语法: 可以用 def 声明一个像 Python 一样动态的灵活函数;也可以用 fn 声明一个强制类型检查、极致安全的严格函数
所有权与生命周期(Ownership & Borrowing): 引入了类似 Rust 的借用检查器(Borrow Checker)。这是 Rust 编译器的核心机制,它在编译期通过一套极其严格的规则来强制管理内存的所有权(Ownership),从而在不需要垃圾回收(GC)且不牺牲运行性能的前提下,从根本上消灭内存安全漏洞
强力支持元编程(Metaprogramming / Comptime): 支持在编译期(Compile-time)执行代码,动态生成、校验或优化硬件特定指令。简单讲,就是将元编程直接与物理硬件指令集进行绑定(Hardware-Aware Compilation)
Mojo 是整个现代 AI 基础设施的架构分层
