

🇺🇸 硅谷 Builder|AI 产品|独立开发|技术管理 👨🏻💻 写代码,也写产品、增长和团队管理 🚀 Build | Ship | Grow 👇 咨询合作注明来意
Joined April 2010
- Tweets11.2K
- Following338
- Followers11.2K
- Likes3.2K





classics-study-room 昨天进了 5 个提交,其中两个改的是同步。
前一个把同步改成按 commit 列出整个仓库,列表存下来复用;index.json 按 sha 判断,没有新增内容就不再重读。后一个是 review 之后的修复:列表里的文件夹前缀统一成 NFC,另外补了测试,覆盖列表落后于仓库的情况。
这两个提交连起来看更清楚。列表存下来复用,就总会有跟不上仓库的时候,后面补的测试正好覆盖了这一步缓存带来的情况。

58 分、13 条评论。HN 今天有个 Show HN 叫 doomformer,作者 falperc,标题只有一句:I Turned DOOM into a Transformer。
我第一眼读成的是:根本不训练,把游戏逻辑直接写进 Transformer 的权重,算出来应该能和原引擎逐帧对上。但它也可能是训练一个模型去学 DOOM 的画面,这种跑久了会漂。两件事差得挺远。
目前公开的只有标题和仓库地址。进仓库先看有没有训练数据和 loss。有,就是在学画面。没有的话更像手写权重,不过也可能只是没把训练记录传上来。
doomformer 的仓库在这,可以先找找有没有训练数据和 loss:github.com/mottopanikeiku/do…


把这个弹窗自动关掉的小工具 dontallow:github.com/johncassil/dontal…

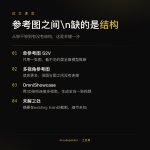
给一个主体拍几张参考照,让模型生成一段关于它的视频,最难的一刻是镜头转到照片里没拍到的那一面。OmniShowcase 这篇论文就是冲着这一刻去的。
摘要里能看出这条路线走过三步。最早的 subject-to-video(S2V)只用一张参考图做条件,镜头一转,主体看不见的外观和几何结构全靠模型去推断。后来的方法改成输入多张不同视角的参考图,关于主体的信息多了,但这些照片之间靠什么 3D 结构连起来,并没有明确交代。模型拿到了几个角度的观测,却不知道它们在空间里怎么接。OmniShowcase 的标题写的是从多视角图像生成「全向」、主体一致的视频,要补的就是这段连接。
这篇值得看的地方在于,它把问题从「参考图够不够」挪到了「参考图之间有没有结构」。张数加上去,看不见的面会变少,可两张照片之间的部分还是要靠模型自己拼。摘要开头点的难点也正在这里:镜头露出的,恰好是输入里没出现过的表面。
做压缩感知出身的人对这个直觉会很熟:观测少的时候,补全主要靠对结构的先验,光加样本不够。
有一点我拿不准。素材里的摘要到「existing train」就断了,后半句没显示全。它具体用什么方式把 3D 结构显式交给模型、比多参考图方法好多少,这段摘要里都没写。HF 上目前 47 个赞、2 条评论,讨论还少,细节得去看正文。


FastVideo 在 Hugging Face 上新挂了一个 Space,叫 FastH3-Omni。现在 50 个 like,trending 值 33。
名字里有 Omni,我第一眼以为一个入口就能出图、出视频。但页面上就两行:Gradio,部署在 us。支持哪些模态、背后用的是哪个模型,页面都没写。
想确认支持啥模态,直接翻 Files 里的 app.py 就行。里面写着加载了哪些模型、界面上有几个输入输出框。
Gemini 4 Carbon 今天发布。Google DeepMind 这次主打网络安全和长程智能体。三项安全跑分放在一起看,三个分数之间的差距比"领先"两个字更值得看:
• SEC-bench Pro 88.2%,三项里最高,离满分已经不远。
• CWE-bench 71.0%,排中间。
• ExploitGym 只有 54.8%,和 SEC-bench Pro 差了一大截。就算是领先的模型,这一项也有将近一半没拿下,安全智能体还有多少空间要看这一项。
• Artificial Analysis Intelligence Index v5.0 拿 59 分登顶,说明押注安全方向没有拖累综合排名。
