

著書『データ分析力を高める ビジネスパーソンのためのSQL入門』 https://xitter.cf/t.co/3Nj9rSawJX | 外資系コンサルシニアマネージャー ◀︎ ebookjapanでデータサイエンス組織の部長 ◀︎ Yahoo! JAPANでWebエンジニア | 複業でマーケティング・データ分析・コーチングなど
Joined July 2010
- Tweets16.4K
- Following491
- Followers3.7K
- Likes3.5K




Pinned Tweet
ついに本日SQLの入門書が発売になりました!
自分自身が過去にSQL勉強会として実施した内容を体系化して1冊の本にまとめました。
240ページとコンパクトにまとめたので、
SQLを学んでデータ分析力を高めたい人が読む最初の1冊としておすすめです!
amazon.co.jp/dp/4297134438/

生命科学分野のRDF講習会資料「RDF入門」。オントロジーのクラスを「集合」、インスタンスを「集合の要素」として説明していて、基本を押さえるのに分かりやすい。生命科学は日本でもオントロジー活用が最も進んだ分野の一つなので、企業が参考にできる蓄積は多い気がする。
wiki.lifesciencedb.jp/mw/ima…

日本のセマンティックWebの定番「ウェブのオントロジー言語OWL」の解説。「子孫」は推移的、「夫婦」は対称的、「ISBN」は値から主語が特定できる、といった例で関係の性質を説明している。OWLの具体的な記述例があるので理解の参考になる。
kanzaki.com/docs/sw/webont-o…
IPAが公開しているOWLの解説資料。行政のデータ整備の文脈で、オントロジー言語を日本語で体系的に学べる数少ない資料だと思う。製品ごとの「オントロジー」を比べる前に、標準としてのOWLを一度押さえておくと理解が速い。
ipa.go.jp/digital/data/nq6ep…


知識グラフとオントロジーを使ったAIシステム開発を、日本の研究者が解説した論文。法造の開発者が書いているので、オントロジーが知識表現を統一する役割についての説明に説得力がある。製品の話題が多い中で、学術的な土台を日本語で押さえられるのは貴重。
jstage.jst.go.jp/article/ess…
オントロジーの推論をPythonのOwlready2で実際に動かした記事。「事実+ルール→新しい事実」という再現性のある導出は、LLMの推論とは全くの別物。確率的なLLMと決定論的な推論を組み合わせる方向性を理解する入口として参考になる。
zenn.dev/aws_japan/articles/…

AIエージェントを「動かす」データ基盤を3ステップで整理。
tech.every.tv/entry/2026/07/…
①参照できる:メダリオンアーキテクチャで品質保証されたGold層だけをAIに見せる
②解釈を間違えない:セマンティックレイヤーで指標の計算式を一元定義
③行動できる:オントロジーで業務の関係を可読にする

DatabricksのGenieが分析アシスタントから「AI Coworker」へ大きく変化。対話で依頼した定型業務をそのままエージェント化できる流れと、その精度を支えるGenie Ontologyの位置づけが分かる。オントロジーが製品の裏側の部品として組み込まれていく流れが注目。
zenn.dev/nttdata_tech/articl…

Microsoft Fabricのオントロジー機能を解説した記事。StoreやSaleEventといった業務用語をエンティティ型として定義し、データと結びつける。「オントロジーはAIのための特別な仕組みというより、説明できるデータ基盤の延長線」という捉え方が良い。
zenn.dev/headwaters/articles…

オントロジーによって「データ」ではなく「意思決定」をモデル化する動きが注目。Palantirは概念(名詞)だけでなくロジック・アクション(動詞)・権限まで一体で扱い、AIが読むだけでなく承認や更新まで安全に実行できる土台として設計している。
product.hiway.app/blog/ontol…

「オントロジーとは何か」の整理。オントロジーをAIエージェントにとっての3つの役割に整理しているのが分かりやすい。
zenn.dev/komlock_lab/article…
①認識:AIエージェントが世界を見るための地図
②行動:権限と承認フロー込みのAPIカタログ
③組織:AIと人間が共通言語で動くための「業務OS」

オントロジーの定義から効果の実証データを整理した記事。
fd-x.co.jp/insights/41-what-…
・同じデータ/LLMでもSQL直接だと正答率16.7%、ナレッジグラフ化で54.2%、オントロジーで72%まで伸びる
・2026年の最新モデルでも、セマンティックレイヤー経由は98〜100%、SQLを書かせる方式は84〜90%と差が残る

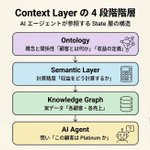
Salesforceによるオントロジーの解説。「データはつながっても意味はつながらない」という一言が分かりやすい。タクソノミーは「分類」、ナレッジグラフは「実データの地図」、オントロジーは「意味と関係の設計図」という整理も分かりやすい。
salesforce.com/jp/blog/jp-wh…

セマンティックWebがなぜ推論できる仕組みにならなかったかを分析した論文。事実を「主語・述語・目的語」だけで表すと、いつ・どの条件で・どの根拠で成り立つかが抜け落ちてしまうという指摘は、企業のオントロジー設計でもそのまま当てはまる気がする
arxiv.org/abs/2609.14121

A/Bテストで「有意差が出るまで待つ」ことの代償を論じた記事。問いを「統計的に有意か」から「どの選択肢が最悪の機会損失を最小化するか」に変え、推定効果が導入コストを上回れば実施するというAMMRの考え方がとても参考になる。
dhbr.diamond.jp/articles/-/1…

ベンダーのFDEが作ったAIエージェントの70%は2028年までに放棄されると予測。技術的に失敗する前に構造的に失敗するという指摘がとても鋭い。FDEが去った後も現場で使い続けられるよう、知識の移転と出口戦略を最初から設計しておくことが鍵だと感じる。
publickey1.jp/blog/26/fdeai7…

ナレッジグラフを数十件作ってきたオントロジストが「成功より失敗の方が多い」と認めた上で原因を整理した記事。技術より進め方の問題が大きいという指摘が参考になる。
ontologist.substack.com/p/wh…
・上位オントロジーから深い継承を先に作ると、必要なクラスが後から分かって破綻する
・全社1つの巨大なグラフより、小さなグラフを分散させてつなぐ方がうまくいく
・グラフをLLMのコンテキストに詰め込むとトークンが膨らむので、必要な分を問い合わせさせる
AnthropicがClaudeの新機能「Claude Dashboards」をベータ公開。SnowflakeやDatabricks、BigQueryなどに接続し、自然言語の指示だけでダッシュボードを自動生成できる。SQLを書かなくても分析できる時代になったけど、その数字が正しいかを確かめることが重要になる。
news.mynavi.jp/techplus/arti…

Databricks GenieでECのKPIを聞いたところ、5問中正解はゼロ。キャンセルを除外するルールや割引額の定義をSQLで登録していくと、全問正解になった。「もっともらしい間違い」を消すのはモデルではなく業務ルールの定義だということがよくわかる好事例。
tech.every.tv/entry/2026/04/…

3つのLLMでセマンティックレイヤーの効果を検証したベンチマーク。指標の意味や判断ルールを書いたMarkdownを渡すだけでどのモデルも正答率が17〜23ポイント向上。しかもLLMモデル間での差はない。AI分析の品質の上限を決めるのはデータモデル側という結論がとても重要。
cube.dev/blog/why-semantic-l…

Anthropicのデータサイエンスチームが社内分析にClaudeを使った知見。問題はクエリを書くことではなくどれが正しいクエリかを見極めること。
atscale.com/blog/anthropic-a…
・過去のSQLやダッシュボードを大量に読ませても精度向上は1%未満。精度に効くのはトレーニングデータを増やすことではなく構造
・意味レイヤーではなく指標の定義や使うテーブル・フィルタをスキルファイルに書く「意味スキル」を構築
・正答率は21%から95%へ改善し、一部の領域では約99%
・セマンティックレイヤー経由にしたある大手銀行の事例では計算コストを最大2万1000分の1に削減
