

闻鸡起舞,骑猫看世界。 科技圈摸爬滚打多年,依然好奇,依然在路上。聊 AI/SI、科技和知识,偶尔钓鱼 🎣 AI / SI · Tech · Knowledge · Exploring
银河边 · 钓鱼中 🎣
Joined June 2025
- Tweets11.2K
- Following3.2K
- Followers3.7K
- Likes16.3K




Pinned Tweet
你昨天在 X 上到底干了啥???
做了个 X Pulse bot,把一整天变成一段会放电的表盘回放,可交互,可随意调整。
🧠 发帖、回复、引用按时间亮起,连成神经通路,哪段最活跃一眼就能看出来
🌊 曝光越高涟漪越大,互动越多光点越亮
🎯 圆心是头像和当天数据,状态词随热度从「静候」变到「爆发」
🎵 三种背景音乐,跟着画面节奏走
🎬 三套风格、三种画幅,一键录屏
📅 默认回放昨天,最多 7 天,中英双语
导入就能用,bot 只通过 X API 读数据,不碰你的账号,感兴趣的兄弟们欢迎玩玩!!!
也欢迎晒出你的脉搏视频!! @poteto
👉 x.ai/bot/WXXQICyJA3NiSUumZ8u…
Anthropic 都快上市敲钟了,Claude Code 产品负责人 Cat Wu 宣布离职,她陪着 Claude Code 从一个内部小工具,一路做成了行业标杆!!!
好奇她接下来的去向,也更好奇她的职业生涯!!!
Cat Wu的履历,和土豆姐Lauren一样,相当能打:
🎓 普林斯顿计算机系,毕业设计就是和 6 个朋友一起做的白板应用,进了学校的创业项目
🚀 Scale AI 第 20 号员工
💰 Index Ventures 合伙人,当投资人还天天自己写代码
🤖 用 Claude Code 写项目几百个小时,一行代码没手写,直接被圈粉入伙
🦇 和 Claude Code 之父 Boris 号称「80% 心意相通」,被称作 Anthropic 的「蝙蝠侠与罗宾」
🔄 去年两人一起跳槽 Cursor,两周后又一起回了 Anthropic
👜 疫情在家没事干,自学做皮包,做出了一整个系列
她说过:代码越来越便宜,值钱的是决定写什么。


鸡骑猫 retweeted

Friday was my last day at Anthropic.
Two years ago, when Claude Code was a small internal tool, I asked it to build an RL env. I steered it for tens of hours but never manually wrote a line of code. It worked, I was hooked, and I joined the team.
When we first launched, most people approved every permission prompt by hand and mostly used Claude to answer questions and write tests.
Today, the default is trusting Claude's judgment to auto-approve. Claude does large migrations and builds new products.
Helping build Claude Code into an industry-defining product has been the journey of a lifetime.
Thank you to the incredible team behind Claude Code, Cowork, and Tag. These products are the sum of thousands of great ideas from you. I'll miss working with you all.
Thank you to our users for embracing a new way of working. Your constant feedback shaped so much of what we shipped and your stories made the work so meaningful.
Excited to see what you all make next!


鸡骑猫 retweeted
一年半要上 13GW,SemiAnalysis 敢写,马斯克当然敢转。
SpaceX 要做全球最大的 AI 云!!!
所以火箭和车其实都只是副业???

Elon Is Doing It Again: SpaceX Will Be The World’s Biggest AI Cloud
Making 13GW in 1.5 Years A Reality
newsletter.semianalysis.com/…


这世界 ™ 的就是荒诞、离谱!!!
世界上最厉害的人工智能公司 OpenAI(Anthropic 说:滚一边去)
一边说人类不能把未来交给 AI
一边又不断加速造超级智能❗❗❗
到底是不想AI掌控,还是不想其他人掌控❓❓❓

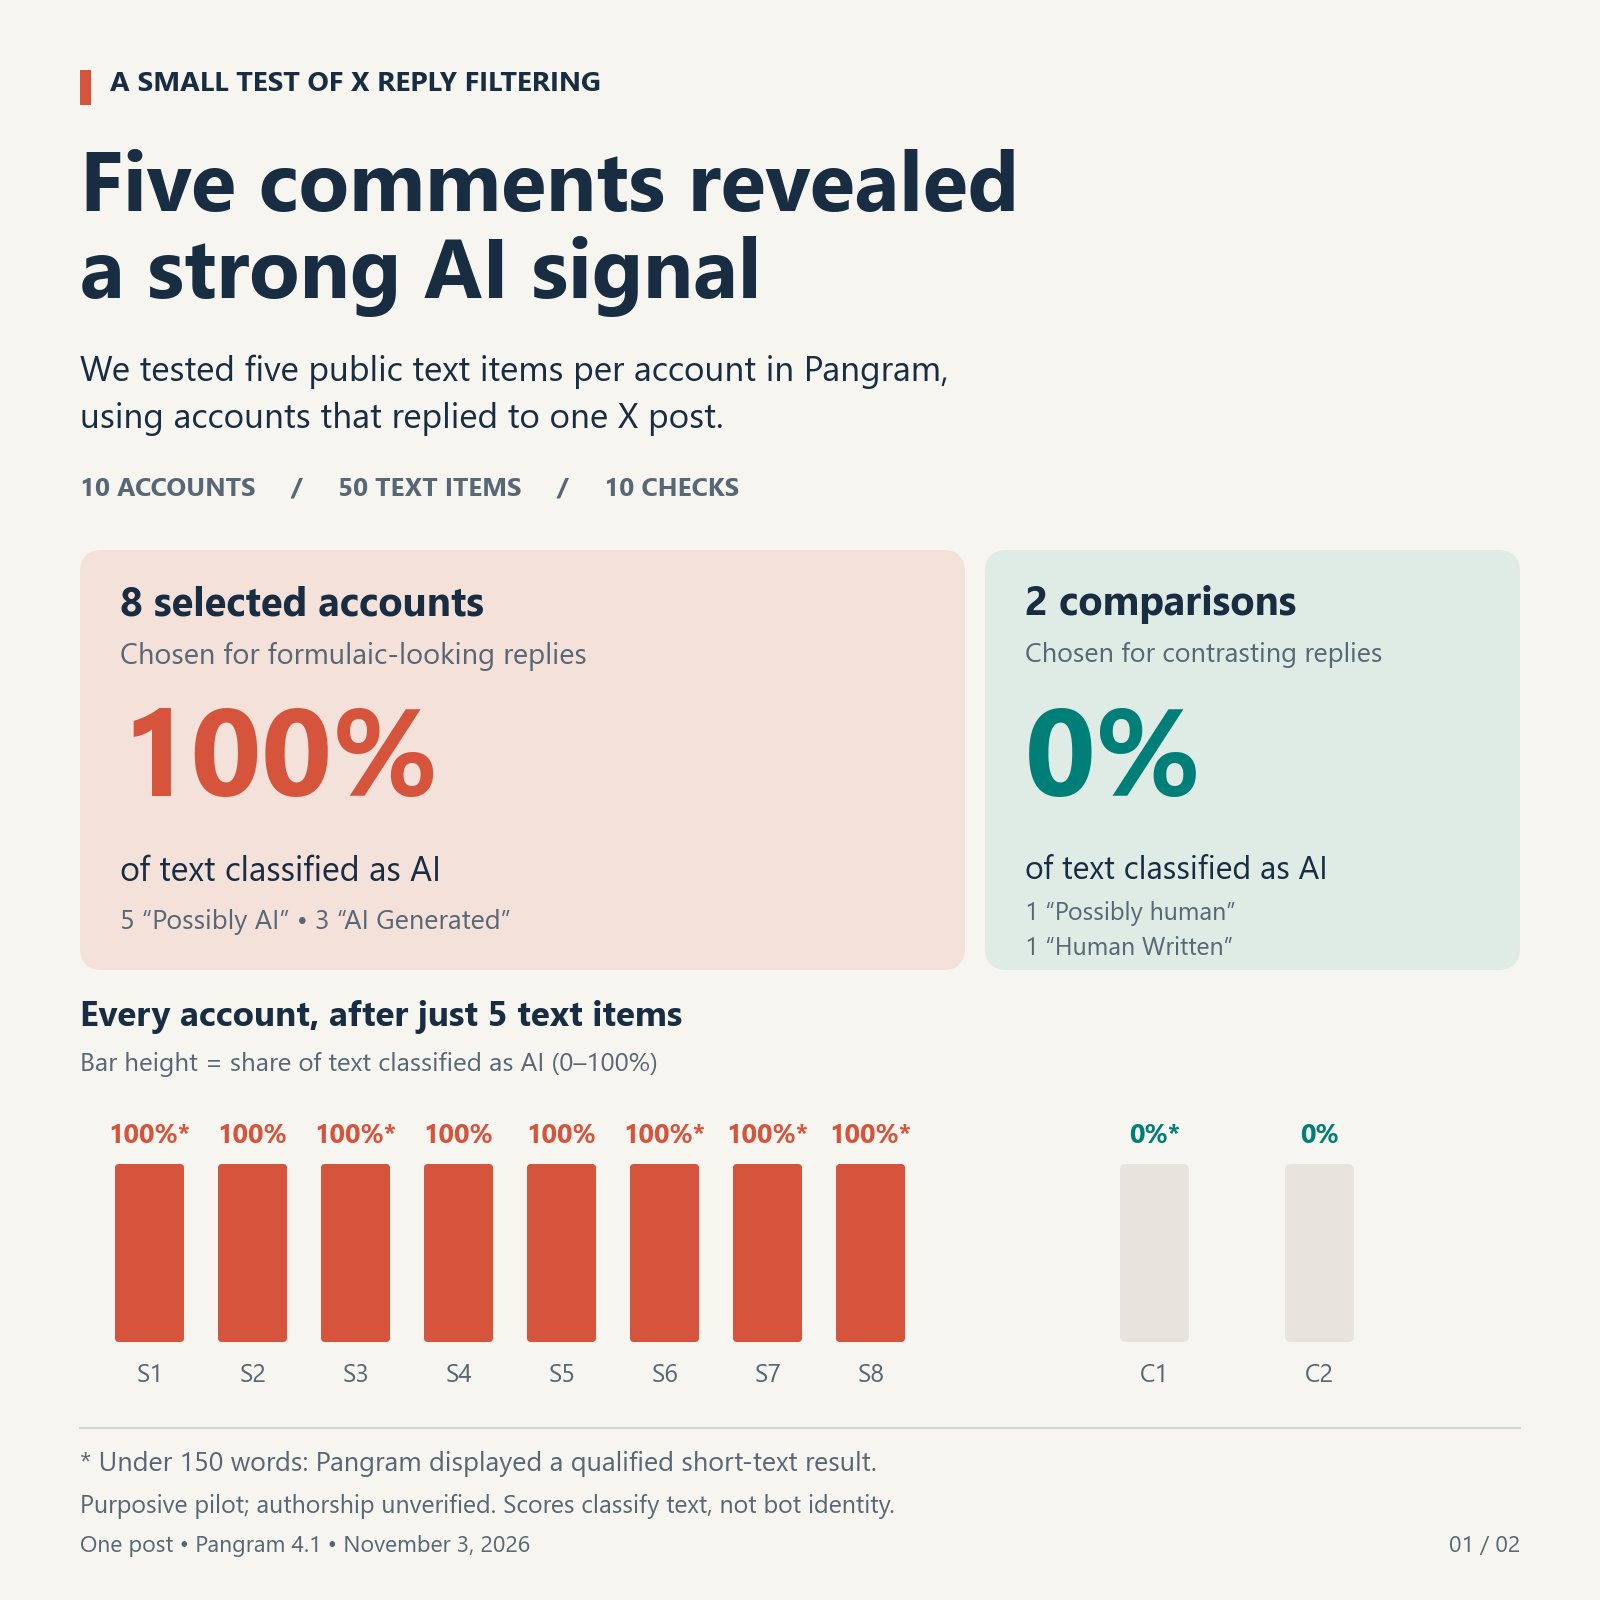
看来 AI 机器人评论泛滥不是中推独有的,全球都泛滥
要治理应该不难,emollick 说这事很好治,一个号的五条评论放一起测一下,就知道是不是 AI 在刷
方法很多,但 X 为什么就不治呢?

鸡骑猫 retweeted
记录下昨晚成果:
本着不浪费 token 的原则,让 zcode+GLM 5.3-Flash 把我收藏的一批视频做成了知识笔记:不是存标题和链接,是把口播里讲的东西逐条拆成步骤、参数、资源清单。
17 条视频,3 个半小时的音频,从抓取到成稿 90 分钟。我只在前10分钟出手了两次:扫码登录,点了一次人机验证。(总计消耗 3800 万token)
中间就睡觉了,剩下全是它自己解决的,而且遇到的问题比我预想的多:
1)想走捷径调官方接口,一重放就被风控打回一页 HTML。它尝试一次发现后就没硬来,换道从网页播放器里把音频直链抠了出来
2)视频封装格式不统一,长短两种文件各写了一条提取分支
3)转写模型下载卡死在 0%,它测了个速,判断是下载器的问题不是网络,换镜像加断点续传搞定
4)CPU 转写按原时长慢慢磨,它直接换了芯片加速方案,13 分钟的视频 2 分钟转完
5)翻页太快触发了验证码,它不代点,改成每页间隔 4 秒,后面十几页零触发(这个是我没想到的,不然中间肯定就中断了)
6)个别视频压根没有口播,它老实标注"这条需要人看"
整体处理方式很主动和不断尝试:
每一步先探测再动手——看日志、看文件头、测下载速度,确认问题再思考方案尝试;
一条路堵了立刻换路,绝不在原地重试。
这个过程还是很有意思的,各家agent工具都在不知不觉中迭代了很多,看 agent 能不能用的标准:不是不遇到问题,是不把问题留给你。
下次再跑同样的活,直接复用这次沉淀的管线,连踩坑文档它都自己写好了。


一年半要上 13GW,SemiAnalysis 敢写,马斯克当然敢转。
SpaceX 要做全球最大的 AI 云!!!
所以火箭和车其实都只是副业???
Elon Is Doing It Again: SpaceX Will Be The World’s Biggest AI Cloud
Making 13GW in 1.5 Years A Reality
newsletter.semianalysis.com/…
记录下昨晚成果:
本着不浪费 token 的原则,让 zcode+GLM 5.3-Flash 把我收藏的一批视频做成了知识笔记:不是存标题和链接,是把口播里讲的东西逐条拆成步骤、参数、资源清单。
17 条视频,3 个半小时的音频,从抓取到成稿 90 分钟。我只在前10分钟出手了两次:扫码登录,点了一次人机验证。(总计消耗 3800 万token)
中间就睡觉了,剩下全是它自己解决的,而且遇到的问题比我预想的多:
1)想走捷径调官方接口,一重放就被风控打回一页 HTML。它尝试一次发现后就没硬来,换道从网页播放器里把音频直链抠了出来
2)视频封装格式不统一,长短两种文件各写了一条提取分支
3)转写模型下载卡死在 0%,它测了个速,判断是下载器的问题不是网络,换镜像加断点续传搞定
4)CPU 转写按原时长慢慢磨,它直接换了芯片加速方案,13 分钟的视频 2 分钟转完
5)翻页太快触发了验证码,它不代点,改成每页间隔 4 秒,后面十几页零触发(这个是我没想到的,不然中间肯定就中断了)
6)个别视频压根没有口播,它老实标注"这条需要人看"
整体处理方式很主动和不断尝试:
每一步先探测再动手——看日志、看文件头、测下载速度,确认问题再思考方案尝试;
一条路堵了立刻换路,绝不在原地重试。
这个过程还是很有意思的,各家agent工具都在不知不觉中迭代了很多,看 agent 能不能用的标准:不是不遇到问题,是不把问题留给你。
下次再跑同样的活,直接复用这次沉淀的管线,连踩坑文档它都自己写好了。
鸡骑猫 retweeted
中转站偷换模型的好日子,又又又可能要到头了???
Anthropic 开源了 FlashProve,能给每条回复出一份证明,查是不是承诺的那个模型答的。
现在还是原型,限制还比较多:
只跑 Llama 4 Maverick,上下文 1024
出证明的 GPU 时间,是正常推理的 70 到 95 倍
仓库自己写着:研究原型,不维护
中转站要是肯多花几十倍成本出证明,那也不叫中转站了!!!
github.com/anthropics/FlashP…


鸡骑猫 retweeted

NVIDIA Auto Ontology:让AI查企业数据时不再瞎编乱造
企业让AI查数据时经常遇到麻烦,AI往往分不清各种业务术语的具体含义,算出的收入和指标经常出错,普通人根本不敢信任AI给的财务和业务结果。
针对这个痛点,NVIDIA开源了Auto Ontology项目,利用FastAPI、Postgres、Better Auth和NVIDIA NIM模型搭建了一套语义理解层,把复杂的数据库表结构自动整理成清晰的业务关系图谱,并接入统一的查询接口。
接入这套系统后,团队成员只要在网页端用日常大白话提问,AI就能精准理解问题背后的指标定义,自动生成严谨的SQL语句去数据库查出准确数据,每次回答还会附带清晰的数据来源与逻辑依据,避免凭空胡编。
GitHub:github.com/NVIDIA/auto-ontol…
