





Basaltで直列と並列どちらが短時間により多くのリクエストを処理できるのか検証した
■ 何をしたか
128k入力 x 8並列同時リクエストで全件完了までの挙動を実測
■ 結果:8件完了までの所要時間
8スロット 352秒
4スロット 290秒
2スロット 254秒
1スロット 187秒
→ 並列スロット増やすほど全件完了が遅れた
■ 感想
直線番長系のBasalt, Strataでは無理に並列実行しない方が現時点で良さそう
並列での合計スループット改善も現在取り組んでいるが劇的な改善は今のところなさそう
■ 構成
重み: IQ3_S
推論エンジン: Basalt MTP 4 / KV int8
入力: 127k 散文 ×8 を同時送信
計測: 各3回の中央値

PC購入調査して感じたけど、組み立てや実測報告にかなり助けられている
荒い情報や食い違いがあっても、それ含めてChatGPTやClaudeに詳細調査させるいいテーマになり注意すべきポイントが明確になる
小型PC構築にあたって組み立てが成立するか、どの程度の処理性能が見込めるか購入判断がかなり楽になった
最近パーツに興味を持った私みたいな人は2枚組で96GB 128GB 店頭で見たことないと思う
中古ddr5 128GB が35万でひっそり残ってたのを見かけたけどそれだけ

🚨【2026年11月2日|ドスパラ大阪・なんば店 メモリ価格表】
DDR5メモリ、価格がヤバすぎる…😱
📍店舗価格をチェックすると…
💥 DDR5-5600 64GB:163,800円
💥 DDR5-6000 32GB:約76,000~100,000円台
💥 DDR5-5600 16GB:約35,000~40,000円台
💥 DDR4-3200 32GB:約35,000~45,000円台
DDR5だけでなく、DDR4まで高いのが厳しい…。
これから自作PCを組む人は、メモリ予算をかなり多めに見積もる必要がありそうです。
この価格、いつまで続くと思いますか?
#自作PC #メモリ #DDR5 #DDR4 #ドスパラ

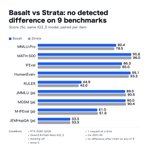
Basalt と Strata で出力品質に目立った差はなかった
C1 256kに限定して言えば、Basaltが目立った劣化なくprefill decode共にStrataを上回っている
256k入力におけるBasaltの計測結果(Strata 比)
Prefill 5925 tok/s(+9%)
Prose 270 tok/s(+48%)
Code 278 tok/s(+20%)
※CPUにkvキャッシュを寄せた改善版


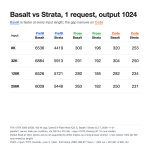
Basalt vs Strata 最大256k入力、1リクエストに焦点をあてて実測した
主に1セッションでの長コンテキスト利用を想定してBasaltがどうなるか
■ 結論
・Basaltが256k含む1リクエストの各指標でStrataを上回った
・256kでBasaltのCodeがProseを下回る逆転現象に遭遇したが、KVキャッシュをCPU側に移すと改善した
Ryzen 7 9700X+RTX 5090(400W)+DDR5-3600 128GBでの測定
■ prefillは?
各入力長でBasaltが優位
32k〜256kでは500-1000tok/s優位だが、256kの長文prefillではStrataとの差が500tok/s程度に縮んだ
■ decodeは?
基本的にはBasalt優位だが、256kにかけて差は縮小した
Proseで1.45〜1.53倍、Codeで1.08〜1.26倍
■ Basalt 256k で CodeがProseと逆転するのはなぜ?
入力長の増加によりKV CacheがGPU上のExpert Cacheを圧迫するためと考えられる。
256kではExpert Cacheの容量が14%減少しCPU側で処理するExpertが増えたことが観測できた。
■ なぜCodeが256kで落ち込む?
CodeのMTPは256kにおいても高い受理率を維持し貢献している(受理率 Code 83% : Prose 66%、1回あたりの生成量 Code 3.12 : Prose 2.10トークン)
しかしCodeはProseより使うExpertの種類が多く分散しているためGPU上のExpert Cacheでヒットしにくい(Code 91.7% : Prose 96.4%)
MoEモデルの各層においてMTPの1回の検証あたりCPU側で処理するExpert数の平均は256kでCode 2.49、Prose 0.78と約3倍
長文入力によるExpert Cache容量の減少でCode側が影響を強く受ける
■ 具体的にどれくらい影響がある?
8k→256kでCPU側Expert処理時間は
・Code 4.26→6.46ms(+2.20ms)
・Prose 1.40→1.94ms(+0.54ms)
CodeはCPU処理時間の増加が約4倍大きい
MTPの受理率はほぼ変わらないものの、CPU側の処理が重くなりDecode速度が逆転した
■ 改善策:KV CacheをCPU側に移すと256kでCode出力速度が改善
Basalt 256k Decode(tok/s)
・Code 246→278(+13%)
・Prose 261→270(+3%)
Expert Cacheの容量が回復しCodeが再びProseを上回った
長文を1セッションで利用するなら、KV CacheをGPU上に保持するよりExpert Cacheの容量を確保した方が速い結果となった
Prefillはほぼ変わらない(−1%)
■ 感想
長文脈利用でもBasaltは本当に使い物になるのか?という疑問に対して、今回の結果を見るに1セッションなら問題なさそう
並列性能についても計測しているが、Basaltの初回応答までの効率が落ち128K×8の完了時間はStrataが約2割短い結果が今のところ出ている
次は並列性能の評価と改善策を検証する予定
■ 結果表 (tok/s)
入力長 8k|32k|128k|256k
Prefill
- Basalt 6536|6884|6526|6009
- Strata 4419|5913|5721|5449
Decode Prose
- Basalt 300|291|280|263
- Strata 196|192|185|182
Decode Code
- Basalt 320|304|282|250
- Strata 253|250|234|231


小型デスクトップの興味が再燃してる
手持ちのDDR5 32GBを流用する前提で15万以内に収めるとして
ベアボーン:DeskMeet X600(8L)
CPU:AMD Ryzen 5 7600
クーラー:付属
RAM:(手持ちDDR5 32GB)
GPU:3060 12GB中古
SSD:500GB~1TB 安価なもの
CPUをRyzen 7 9700Xにしたらクーラー含めて+2万だが割り切りマシンには過剰かな
拡張性は
・RAM:DDR5を4枚OK、最大256GB(CPU依存)
・GPU:5060Tiも動確リストにあり
雑に扱える常駐小型AIサーバー
自分の環境だとやはり箱に収めたい


Basalt vs Strata 最大256k入力、1リクエストに焦点をあてて実測した
主に1セッションでの長コンテキスト利用を想定してBasaltがどうなるか
■ 結論
・Basaltが256k含む1リクエストの各指標でStrataを上回った
・256kでBasaltのCodeがProseを下回る逆転現象に遭遇したが、KVキャッシュをCPU側に移すと改善した
Ryzen 7 9700X+RTX 5090(400W)+DDR5-3600 128GBでの測定
■ prefillは?
各入力長でBasaltが優位
32k〜256kでは500-1000tok/s優位だが、256kの長文prefillではStrataとの差が500tok/s程度に縮んだ
■ decodeは?
基本的にはBasalt優位だが、256kにかけて差は縮小した
Proseで1.45〜1.53倍、Codeで1.08〜1.26倍
■ Basalt 256k で CodeがProseと逆転するのはなぜ?
入力長の増加によりKV CacheがGPU上のExpert Cacheを圧迫するためと考えられる。
256kではExpert Cacheの容量が14%減少しCPU側で処理するExpertが増えたことが観測できた。
■ なぜCodeが256kで落ち込む?
CodeのMTPは256kにおいても高い受理率を維持し貢献している(受理率 Code 83% : Prose 66%、1回あたりの生成量 Code 3.12 : Prose 2.10トークン)
しかしCodeはProseより使うExpertの種類が多く分散しているためGPU上のExpert Cacheでヒットしにくい(Code 91.7% : Prose 96.4%)
MoEモデルの各層においてMTPの1回の検証あたりCPU側で処理するExpert数の平均は256kでCode 2.49、Prose 0.78と約3倍
長文入力によるExpert Cache容量の減少でCode側が影響を強く受ける
■ 具体的にどれくらい影響がある?
8k→256kでCPU側Expert処理時間は
・Code 4.26→6.46ms(+2.20ms)
・Prose 1.40→1.94ms(+0.54ms)
CodeはCPU処理時間の増加が約4倍大きい
MTPの受理率はほぼ変わらないものの、CPU側の処理が重くなりDecode速度が逆転した
■ 改善策:KV CacheをCPU側に移すと256kでCode出力速度が改善
Basalt 256k Decode(tok/s)
・Code 246→278(+13%)
・Prose 261→270(+3%)
Expert Cacheの容量が回復しCodeが再びProseを上回った
長文を1セッションで利用するなら、KV CacheをGPU上に保持するよりExpert Cacheの容量を確保した方が速い結果となった
Prefillはほぼ変わらない(−1%)
■ 感想
長文脈利用でもBasaltは本当に使い物になるのか?という疑問に対して、今回の結果を見るに1セッションなら問題なさそう
並列性能についても計測しているが、Basaltの初回応答までの効率が落ち128K×8の完了時間はStrataが約2割短い結果が今のところ出ている
次は並列性能の評価と改善策を検証する予定
■ 結果表 (tok/s)
入力長 8k|32k|128k|256k
Prefill
- Basalt 6536|6884|6526|6009
- Strata 4419|5913|5721|5449
Decode Prose
- Basalt 300|291|280|263
- Strata 196|192|185|182
Decode Code
- Basalt 320|304|282|250
- Strata 253|250|234|231

なんというか逆の視点でハッとしたけど
Anthropicらは自社モデルのノウハウ、一部能力を出し惜しみ限定公開して利益に繋げる一方でモデルにバックドアを仕込む攻撃側の手法を簡単に公開するのに違和感ある
既存モデルに仕込まれたバックドアを検出する手法にはノータッチ
Data curation and provenance:学習データ検査難しいね
Deployment-time defense:モデル実行時制御頑張ろう
にはは言及しつつも
・バックドアやトリガーの検出手法
・バックドア検出器の精度評価
など防御側の武器について言及してくれていない
最高峰のフロンティアモデルがあるのに
オープンモデルへの不安を煽って、クローズドモデルに誘導するマーケティングに見えてくる

地元のLLMコミュニティのために武器を渡したいので暇なとき一緒に対策をしていこうぜ。
ローカルを潰しにかかる大義名分はほぼ間違いなくこれになる。商用LLM依存にさせるためにOpenAIからも刀狩り令(メモリ版)が出てたでしょ。他にもたくさん変なコメントが出てるでしょ?あれは大半がポジショントーク。今回これを書いたのはAnthropic。中身は使えるが利害のある側の論文でもある。
「Agentic Backdoors」の話はウチの構成が偶然対策できてる。Sparkは速度のためにリングで閉じ出口はmacmini一本なのでそこを監視。
「攻撃は実行の前にダウンロードが必要」なのでegressを絞れば発火しても取得の段で切れる。
ただし切れるのは取得と持ち出しの段だけ。ローカル破壊は止まらないので、実行ログと権限で見る。
次は検索まで閉じたくなる。知識は外付けSSD/HDDに溜めて閉じたSparkにつなげて使う。必要分は随時自動収集。100TB級なら主要モデルの学習コーパスと同規模で本当に使える。ただ実用は厳選100GB〜1TBで足りる。SSD=索引とホット、HDD=冷温存、二重化。
ここも検疫だけでは足りない。止まるのは実行ファイルで文書に書かれた毒は消えない。読み込み側の権限で切る。
一番痛いのは頭脳の側。閉じたSparkの重みは外から来てる。そこは閉じられない。だから行動層で切る。
だからSSDとHDDが要ると思ってたんだよ。俺とフォロワーさんだけでもまずは強くなろう。勉強の邪魔されて超迷惑。
