

Radeon AI PRO R9700 本地部署实测。单卡、双卡与三卡同机对照。数字带来源和条件;失败也写。独立实测,非官方。
Joined October 2023
- Tweets489
- Following910
- Followers837
- Likes105




Pinned Tweet
2× Radeon AI PRO R9700 + SGLang + ROCm 7.2,Qwen3.8-Flash-Next EXL3 3.05 bpw(MTP 3 步 / 262144)。2026年10月本机:
• 单路 130.6 t/s
• 8 路约 375 t/s(374.9)
非官方成绩。
blog.i8i8.xyz/posts/flash-ne…

5
20
487
海螺 H3-Image 基准跑完了:一条提示词,一次 4 张,4K 21:9。橘猫、木窗台、雨夜霓虹全对上了,第三张红色 HOTEL OPEN 霓虹招牌挺出片。12 积分,一批 4 张约 1 分钟,比官方说的 10 秒慢,主要耗在排队。本地 R9700 那边 BF16 全量 135GB 装不下,下一步看量化能不能塞进单卡。

2
3
104
同题对比:Qwen4-Max vs 某 3.1 Pro,各做一只骑车的鹈鹕。左边 Qwen:动画能跑,但画面素,代码编辑器还摊着,像个测试页。右边 3.1 Pro:直接是成品海报,大标题、橙色底、红围巾、嘴里叼条鱼、海浪全齐。完成度差得挺明显,视频自己看。
2
165
算了笔账:H3-Image 主模型 BF16 68.65GB,文本编码器 Qwen3-VL-32B 还要 66.7GB,加起来 135GB+。单张 R9700 32GB,BF16 原样肯定装不下,三卡 96GB 也不够全驻留。先走 API 跑个基准,再看量化/卸载路线,不盲下 135GB。
2
4
103
本地硬件跑模型的速度确实上来了。双 R9700 + SGLang 跑 Qwen3.8-Flash-Next,单路 130.6 t/s,8 路 374.9 t/s。数据和条件在置顶帖。
This quoted post is unavailable.
GestaltX 1.0.3 实测能用,记一个坑。
升级到 iOS 27.3 测试版以后,如果手机里插着两张实体 SIM 卡,默认不会出现 eSIM,关掉一张也不行。
要先打开 eSIM 功能,再去「激活设备」里的附加选项。


216
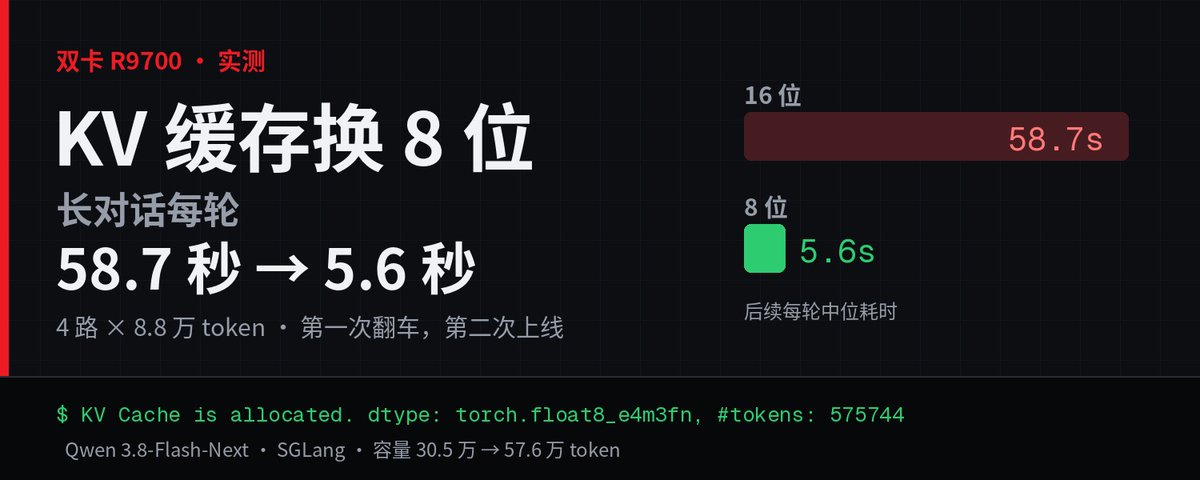
今天把 KV 缓存从 16 位换成 8 位。4 路各 8.8 万 token 的长对话,后续每轮从 58.7 秒降到大约 5 秒;第一次因为自己写的稀疏注意力内核不认 8 位,起不来,改完第二次才过。单路慢了约 7%,8 路短对话的问题还没修好。
4
3
174
下午把今早留下的两件事处理了。
线性注意力的状态槽从 32 个加到 64 个,KV 容量从 57.6 万降到 45 万 token。8 路各 3 万 token 的回放,每请求新算大约 630 个 token,后续每轮中位 9.5 到 9.9 秒;4 路各 8.8 万的长对话仍然正常。
单路慢约 7%,是 Triton 里 8 位转 16 位逐元素做的。改完之后,读缓存的内核时间和 16 位持平,256 个码逐位一致。端到端从 78 回到 80~83 t/s,这个幅度和测量噪声一样大,只能说内核追平了。
完整记录:blog.i8i8.xyz/posts/daily-te…

16
有两项我直接判了不采用。
一是给参考图生视频加的 VSA 稀疏门控:采样没更快,门控还多占约 3.85GB,镜头一路漂、人半出画。
二是 Kandinsky 6 Lite:10 步采样约 77 秒能跑通,但混元视频 VAE 在 ROCm 上试整段、快速、分块,解码 11~23 分钟仍无成片,GPU 一直满载。
速度表好看,成片出不来,就不进生产线。
1
23
值得注意的是,11 月 16 日前用 Fable 5.2,额度是减半的:只占套餐限额的 50%,之后要另算 credits。
刚截完图,主列表里的 Fable 5.1 也不见了,编号从 5 收成 4,应该是被收进 More models。官方还没宣布下架。我已经切到 5.2,先开 Medium。 xitter.gq/claudeai/status/211986…


Introducing Claude Fable 5.2 and Claude Mythos 5.2, designed to tackle the most daunting technical challenges.
They’re capable collaborators on ambitious projects in many fields, and show improvements in areas like coding, reasoning, and vision.
2
58
本地 H3 出片时,音色也值得单独记一笔。
我用 AI 生成的 2~3 秒短参考做对照(还没测真人):女声声纹相似从不带参考约 0.67 提到 0.85 / 0.77;男声约 0.66 → 0.73 / 0.67,提升不稳,每组只有 1 条对照,下不了结论。这几条台词转写全对。
你那边固定音色用真人录音,还是 AI 短参考就够? xitter.gq/kayshen_xu/status/2119…

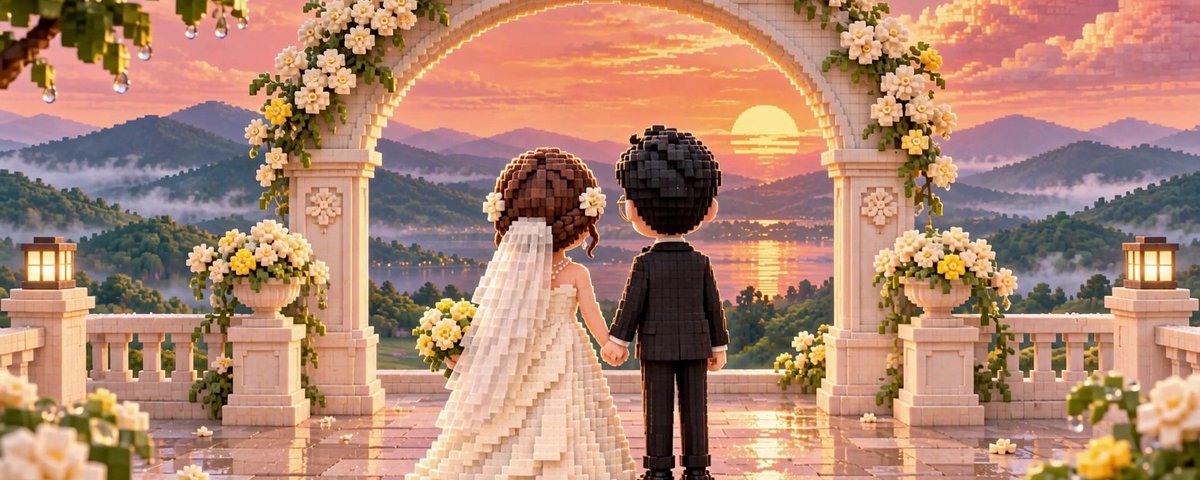
朋友结婚,我用 GPT Image 和本地 MiniMax H3 做了一支 3 分 46 秒的像素婚礼 MV。
大家很喜欢这对像素小人。幕后最离谱的一幕,是本来只想拍雨滴,结果两个人从水里冒了出来。
我把 40 个镜头怎么做、怎么剪写成了教程,附上角色三视图、H3 实测参数和翻车修复对照。
1
64

调视频速度时,耗时最好的那一组,画面其实是坏的。
单卡 R9700 跑 LTX,时间分块试到 128:秒数看起来最优,平均 PSNR 还有约 34,很像能用。抽开看就露馅——最低 PSNR 掉到约 9.9,相邻帧差最大值从基线约 5 飙到约 46。
平均值会把少数坏帧摊平。以后先看最低 PSNR 和帧差最大值,再信「更快」。
1
2
165
Stitched 8×5s AI clips into a 40s take. Segment 1 opened at L* 39.9. Segment 8 ended at L* 30.5 — about 24% darker.
Same prompt, same seed. Independent (non-relay) controls did not show that trend — only ±3–4 content wobble. So the fade was from relay, not the prompt.
Two similar sources:
• inside each clip: ~−0.5 L* on average
• at each join: another −0.4 to −0.5
a*/b* stayed within 1. Color was fine. Brightness alone was enough.
Fix: lift Y' only, only brighter, caps on join (+2.0) and intra-clip (+1.5). After correction, seg8 end came back to L* 37.6 vs seg1’s 39.3. Joins stopped showing a visible step.
Also kept the raw clips. If a prompt is supposed to dim the lights on purpose, the intra-clip cap will fight that a bit — joins still get corrected.
Would you ship a long relay without measuring L* across the chain?
1
31
本地出一段 1080p、5 秒的视频,我从 170 秒砍到了 150 秒,画质没变。
卡是一张 R9700,模型 LTX-2.5。只改了两处:
① 蒸馏版采样根本不用负向提示,工作流却还在花时间编码它,去掉
② VAE 空间分块从 512 提到 1024
170.5 → 149.9 秒(−12%),显存峰值 27.5G。两处都用 PSNR 逐帧对过,不是只看秒数。
720p 同样的改法大约 −5.5%(96.4 → 91.1 秒)。分辨率越高,这两刀越值。
1
2
119
同一张卡,出一张 1024 的图:以前要约 37 秒,现在 11 秒出头。
对照在 7900 XTX 上,权重都是 int8:
• 基座 40 步:1024² 中位 37.3 秒,清晰度(拉普拉斯方差)中位 583
• 官方 Qwen-Image 2.1 Turbo 8 步:11.5 秒,清晰度 442
• LightX2V 的 4 步 Lightning LoRA:8.4 秒,清晰度 469
看图:三种配置中英文大字基本都能写对;Turbo 同种子时和基座最像,Lightning 风格飘得最多。Turbo 清晰度数字更低,水珠和发丝偏少,但 2K 放大后文字和人物仍正常。
注意:直接把基座步数改成 8 是不对的,Turbo 要配固定采样时间表。这组还没进生产;Turbo / 基座都是 Qwen Research 许可,商用要另授权。
完整表和翻车项:
blog.i8i8.xyz/posts/daily-te…

1
125


