

Vera&Company Founder - Cloud and DevOps https://xitter.gq/t.co/C1cjt7QkjB - Open models, Flat fee.
Tenerife
Joined September 2010
- Tweets5K
- Following783
- Followers597
- Likes5.2K


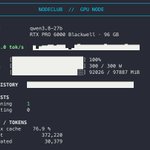


Qwen3.8-27B. Unlimited tokens. One monthly price.
Connect your coding agent to NodeClub and build without watching a token meter.
nodeclub.ai

2
3
2,966
19.297 millones de tokens desde caché, el 92,3 % de los tokens de entrada. De hecho, lo comento en el propio post.
Lo complicado no es generar 21B de tokens desde cero, sino conseguir que muchos socios puedan usar una sola GPU al mismo tiempo, con contextos largos y manteniendo velocidades razonables. Ahí es donde hemos dedicado buena parte del esfuerzo.
Y hombre, más que picar o no, era por conversar y compartir experiencias, que de eso se trata también 😄
15
El 16 de septiembre lanzamos NodeClub con una sola GPU y una idea que, siendo sinceros, no sabíamos hasta qué punto iba a funcionar: ofrecer modelos de inteligencia artificial abiertos con una tarifa plana, sin cobrar por token y operando nosotros mismos toda la infraestructura.
Hoy, apenas dos meses después, acabamos de poner nuestro segundo nodo en producción. Y creo que merece la pena contar lo que ha pasado entre medias, porque hemos aprendido bastante más de lo que esperábamos.
Cuando empezamos, teníamos una NVIDIA RTX PRO 6000 Blackwell de 96 GB y muchas ganas de demostrar que había otra forma de ofrecer inferencia. No queríamos construir otro servicio que simplemente redirigiera peticiones a las APIs de terceros, ni competir por tener el catálogo más grande de modelos. Queríamos controlar toda la cadena: desde el servidor y la configuración del modelo hasta la optimización de la inferencia y la experiencia del usuario.
La propuesta era sencilla: pagas una cuota mensual y puedes utilizar el modelo sin estar mirando constantemente cuánto te cuesta cada petición.
Lo interesante llegó cuando los primeros socios empezaron a utilizarlo de verdad. Muchos no estaban haciendo consultas ocasionales a un chatbot. Estaban conectando agentes de programación, automatizaciones y herramientas capaces de trabajar durante horas. Justamente el uso que queríamos fomentar, pero también uno de los escenarios más exigentes que podíamos encontrarnos.
En octubre procesamos más de 21.000 millones de tokens y 276.000 peticiones. Con una sola GPU. Hubo incluso un día en el que superamos los 1.000 millones de tokens procesados.
Y ahí empezó una de las partes que más hemos disfrutado del proyecto: intentar descubrir hasta dónde podíamos llevar aquel servidor antes de necesitar otro.
Hemos dedicado muchísimas horas a optimizar la inferencia, la concurrencia, la gestión de memoria y, especialmente, el aprovechamiento de la caché. Llegamos a servir el 92 % de los tokens de entrada desde caché y conseguimos que determinadas operaciones sobre sesiones largas pasaran de tardar más de un minuto a aproximadamente un segundo.
Detrás de esas mejoras hay bastantes madrugadas, pruebas que no salieron como esperábamos y mucho tiempo mirando métricas en Grafana. Pero también hay algo que nos parece fundamental: no siempre necesitas más hardware. Muchas veces necesitas entender mejor el que ya tienes.
Por el camino también hemos tenido que aprender a gestionar el crecimiento. Una tarifa plana no significa que los recursos sean infinitos. Significa que nosotros asumimos la responsabilidad de dimensionarlos correctamente. Por eso hemos llegado a limitar nuevas incorporaciones y reservar capacidad para los socios existentes. Podríamos haber aceptado más usuarios, pero no queremos crecer a costa de empeorar el servicio.
Y así llegamos a hoy.
El segundo nodo de NodeClub ya está desplegado y procesando peticiones reales. Otra NVIDIA RTX PRO 6000 Blackwell se incorpora a nuestra infraestructura.
Esto es especialmente importante para nosotros porque no estamos añadiendo otro proveedor a un sistema de enrutamiento. Son servidores dedicados que desplegamos, configuramos, optimizamos y operamos directamente. Esa es precisamente la razón por la que podemos trabajar con un modelo de tarifa plana: conocemos nuestra infraestructura, sus costes y sus límites.
Con esta ampliación ganamos margen para incorporar nuevos socios, seguir mejorando la disponibilidad y preparar la siguiente generación de modelos abiertos, incluido Qwen4 cuando esté disponible y podamos evaluarlo.
También estamos dando nuestros primeros pasos en el mercado empresarial con NodeClub Enterprise. La idea es llevar la misma filosofía a empresas que necesitan capacidad reservada o infraestructura dedicada, sin depender de un modelo de facturación por token para cada interacción con la IA.
Pero, si tuviera que quedarme con algo de estos dos meses, no serían las GPUs ni los miles de millones de tokens.
Sería la comunidad que se está formando alrededor del proyecto. Desarrolladores que comparten lo que están construyendo, socios que nos ayudan a detectar problemas, personas que proponen mejoras y que entienden que detrás de NodeClub hay un equipo pequeño intentando hacer las cosas de una manera diferente.
No tenemos una infraestructura gigantesca ni pretendemos competir en tamaño con los grandes proveedores. Nuestra apuesta es otra: demostrar que, con buenos modelos abiertos, una infraestructura bien optimizada y una comunidad comprometida, se pueden construir alternativas interesantes.
Hace dos meses teníamos una GPU, una idea y muchas incógnitas. Hoy tenemos dos nodos en producción, una comunidad que sigue creciendo y empresas que empiezan a interesarse por lo que estamos construyendo.
Y lo mejor es que seguimos teniendo esa sensación del primer día: todavía hay muchísimo que experimentar, optimizar y aprender.
Seguimos construyendo.
nodeclub.ai
1
1
153
Detrás de cada retuit hay personas. En nuestro caso, un equipo que lleva meses trabajando para construir algo diferente, además de empresas y socios que ya confían en nosotros y utilizan NodeClub a diario.
NodeClub no es un model router. Tenemos infraestructura propia, somos transparentes con lo que ofrecemos y crecemos como un club, no como una empresa de inferencia tradicional. De hecho, estamos desplegando nuestro segundo nodo.
Se pueden debatir precios, modelos y límites, por supuesto. Pero reducir todo a una comparación superficial y calificarlo de estafa es despreciar el trabajo que hay detrás y subestimar a quienes han decidido confiar en el proyecto.
Normalmente no respondo a este tipo de comentarios, y menos de una forma tan personal, pero este nivel de negatividad gratuita me parece completamente innecesario.
Me guardo los adjetivos.
57
Lo servimos directamente desde nuestros propios clústeres de nodos GPU. No depende del hardware del usuario ni necesita descargar nada en RAM. Toda la inferencia se ejecuta en nuestra infraestructura, optimizada para contextos largos y uso concurrente.
1
1
33
Por ahora, por el tamaño del nodo, estamos sirviendo Qwen 3.8. La idea es dar el salto a Qwen 4 en cuanto esté disponible y lo tengamos bien optimizado.
Por cierto, hemos hecho bastantes benchmarks frente a otros modelos y creo que te puedes llevar una sorpresa bastante buena con Qwen :)
Según vayamos ampliando el clúster, iremos metiendo más modelos. Y queremos que sea la propia comunidad quien vote cuáles le interesa tener.
Tienes un trial de 24 horas en nodeclub.ai
1
641
Puedes leer lo que escribí desde los absolutos o desde los grises, como prefieras. Yo intento quedarme con los matices. Viajar y conocer otras realidades me ha permitido apreciar cosas de países con los que no necesariamente comparto su forma de entender el mundo. Creo que una cosa no quita la otra.
1
2
57
Hola, Laura. Te sigo desde hace tiempo y me ha parecido especialmente interesante lo que has compartido estos días.
Este año pasé tres meses en Nueva York y otros mes en China. Poder conocer ambas realidades más allá de una visita turística me hizo reflexionar bastante. Creo que desde Occidente miramos al resto del mundo con una arrogancia enorme, muchas veces sin entender realmente cómo funcionan otras sociedades.
Igual que Manhattan me había dejado muy buenas impresiones en mis anteriores visitas, China también me sorprendió muy positivamente. Y eso no significa que todo sea maravilloso, ni mucho menos.
Sigo pensando que Europa tiene una oportunidad extraordinaria de combinar lo mejor de ambos mundos, añadiendo ese toque europeo de seguridad, derechos y calidad de vida. Eso sí, necesitamos adaptarnos mucho más rápido a los tiempos actuales.
Tampoco creo que estemos por detrás en todo. En España, por ejemplo, tenemos soluciones como Bizum que me parecen fantásticas. Y con la automoción china tengo mis más y mis menos: coches atractivos, tecnología interesante y precios competitivos, pero algunos aspectos de calidad todavía me generan bastantes dudas.
Me ha sucedido algo parecido viajando por Singapur o distintas regiones de Malasia. Cuanto más conozco otras realidades, más convencido estoy de que tenemos mucho que aprender unos de otros y de que nos sobra bastante superioridad moral.
I think the important part of this discussion is the nuance. Qwen3.8:27B isn’t a frontier model, but calling it basic is quite a stretch.
And yes, running local models comes with challenges. But models and inference stacks aren’t static. Hardware requirements, performance and efficiency keep evolving. Also, local doesn’t automatically mean faster, more stable or more private. That depends on the actual architecture and workload.
My company has spent years working on infrastructure and countless hours researching and benchmarking LLM inference, across consumer and enterprise hardware. Today, we operate this service for hundreds of users.
What we’re building isn’t about running Qwen just to prove it works. It’s about making it genuinely usable for real agentic workflows, large contexts, parallel requests and sustained workloads. Other models will come too.
I constantly see people saying “it works for me.” And that’s great, but works for what, exactly? A single conversation? A short prompt? Multiple agents processing large contexts concurrently? These are very different requirements.
The same goes for pricing. Someone says “DeepSeek only costs me €10.” Fine, but for what usage pattern? API pricing is heavily distorted by scale, competition and sometimes subsidized infrastructure. Comparing that with the actual cost of operating reliable inference capacity locally makes things even more complicated.
This isn’t about replacing someone’s hobby setup. It’s about building a viable alternative, an option B or C, for people who genuinely depend on these models to get work done.
I absolutely believe we’ll see incredibly capable models running on phones and consumer hardware. But I also believe enterprise workloads will continue pushing the boundaries of inference infrastructure.
I’m not claiming to have the only correct perspective. But these opinions come from years of infrastructure experience, extensive benchmarking, real operational costs and many, many hours of engineering.
That’s why I think the conversation deserves more nuance than “it runs locally” or “€50 is too expensive.”
2
1
44
Boris Vera retweeted
"Hablar de ti en pasado. Es tremendamente injusto" 💔
Enric Gallego, la voz de un corazón roto, el del CD Tenerife tras la perdida de Jesús de Miguel 😔
No es comparable ejecutar un modelo de 3,3B en una GTX 1650 con usar uno de 27B para tareas de programación agéntica.
Con contextos largos importan la VRAM (pesos + caché KV), la velocidad de procesamiento del contexto (prefill), los tokens/s y la latencia acumulada en cada iteración del agente.
Que un modelo pueda ejecutarse en local no significa que ofrezca un rendimiento viable para trabajar con él.
1
87
Sure, as long as you have the hardware to make it genuinely usable, not just to proudly show off that it can say “Hello World!”
No subscription fees, just a hefty hardware bill.
30
I see comments like this all the time. There’s a huge difference between being able to run a model locally and actually making it usable.
Once you factor in real-world workloads, long contexts, latency, throughput, and concurrent requests, the picture changes dramatically.
Running inference is one thing. Delivering a consistently good user experience is another.
1
22