

Solo-entrepreneur 💰 https://xitter.gq/t.co/y5jyc9Xc0H → entiende tus finanzas
🔥 My projects →
Joined March 2007
- Tweets6.2K
- Following1K
- Followers7.9K
- Likes2.1K






Pinned Tweet
Llevo semanas sin abrir un issue de Sentry.
Y se siguen cerrando solos.
Son dos piezas: mis skills de Claude Code y Herdr, que le da a cada agente su propio sitio donde trabajar.
Cada 2 horas arranca /sentry-issues.
Un agente principal entra en Sentry, mira lo que hay y decide qué merece un fix y qué es ruido.
Lo que merece la pena, lo reparte.
Un worktree por issue, un agente por worktree, cada uno con su servidor levantado. Así ninguno se pisa con el otro.
Y cada agente hace el ciclo entero con /ship:
implementa el fix
pasa dos code reviews
hace QA en el navegador
graba un vídeo de que funciona
abre la PR
dependiendo de la condifence, se auto mergea o no
Por la mañana me encuentro las otras PRs esperando, con el vídeo dentro enseñando que el bug ya no está.
Lo único que hago yo es leerlas y darle a merge.
Las skills son públicas: github.com/victor-falcon/ski…
Te lo enseño funcionando aquí abajo 👇

Google ya no vende su nuevo modelo por lo listo que es. Lo vende por lo que te cobra cada tarea.
Es Gemini 4 Neon, y salió anoche.
Los números del anuncio:
- 3 $ por millón de tokens de entrada y 15 $ de salida. La entrada cacheada, a 0,15 $ (un 95 % menos).
- 1 millón de tokens de contexto.
- AA Index en xhigh: 61, frente a 59 de Claude Opus 5.5 y 57 de GPT-6.2 Sol. Es tercero del ranking general, por detrás de modelos más grandes y lentos.
- En su nivel por defecto (high), un 32 % menos de coste por tarea que Carbon, y entre un 50 y un 80 % menos que los modelos punteros de la competencia, según Google.
Donde no gana:
- FrontierCode 2.0: 46,2 % frente a 47,3 % de Opus 5.5.
- Terminal-Bench 4.1: 65,2 % frente a 65,8 %.
En código puro está empatado con Opus, no por encima.
El dato que más me llama la atención es otro. En SWE-sweep saca un 12,8 % con un harness mínimo y un 39 % con el de Antigravity. Mismo modelo, tres veces más.
A quién le conviene:
- Si tus agentes hacen sesiones largas y lees mucho contexto, la caché a 0,15 $ cambia la factura.
- Si solo te importa el mejor resultado en código, Opus 5.5 sigue un pelín por delante.
- Antes de comparar modelos, compara harnesses.
Guárdatelo para cuando revises qué modelo pones por defecto. Ya está en la API de Gemini, AI Studio, Antigravity (Pro y Ultra) y la app de Gemini.

2
69
El anuncio de Google, con la tabla completa y la metodología: blog.google/innovation-and-a…

13
Impeccable es bastante útil si trabajas con agentes de código (Claude, Cursor, Copilot, lo que uses). Básicamente te da vocabulario de diseño para controlarlos: `/impeccable bolder`, `/impeccable polish`, y así. También crítica y audita lo que generan, y detecta esos patrones que repiten todos los modelos (gradientes púrpura-azul, cards anidadas, iconos redondeados).
Lo mejor es que funciona sobre lo que ya existe. Apuntas a un componente, iteras, y no necesita API keys.
1
78

Anthropic ha soltado su implementación de skills para Claude y vaya tela. Básicamente son carpetas con instrucciones, scripts y recursos que Claude carga dinámicamente para tareas especializadas.
Sirve para cualquier cosa: que genere documentos con la identidad corporativa de tu empresa, analice datos con tus workflows específicos, automatice tareas personales. Lo bueno es que cada skill viene con su SKILL.md con instrucciones y metadatos que Claude entiende.
El repo tiene desde ejemplos creativos (arte, música, diseño) hasta tareas técnicas (testing de apps web, generación de servidores MCP) y flujos empresariales. Algunos están bajo Apache 2.0, así que puedes usarlos de referencia o como punto de partida para los tuyos.

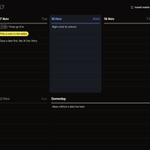
Plain Week ya no tiene un solo layout de escritorio. Tiene tres, y cuál ves depende de la forma de tu ventana.
La gracia de Plain Week es ver la semana entera de un vistazo. Pero la rejilla tenía un alto fijo y en pantallas grandes dejaba media ventana vacía.
Ahora ocupa toda la ventana y se recoloca según su proporción:
- Ventana ancha: de lunes a viernes arriba, y el finde con Someday abajo.
- Casi cuadrada: cuatro columnas y dos filas iguales.
- Alta: 3×3, con Someday ocupando dos huecos.
Y lo hacen tres media queries de aspect-ratio. Nada de JavaScript midiendo la ventana.
Eso sí, cambiar la rejilla rompió dos cosas que no vi venir.
Las tareas que no caben en una celda se salen por abajo, encima de la celda siguiente, y al arrastrar te robaban el drop. Ahora una fila solo cuenta dentro de su propia lista.
Y las flechas del teclado se movían por posición en pantalla. Con una rejilla de 3×3 eso ya no tenía sentido, así que ahora siguen el orden de los días: del jueves pasas al viernes aunque esté en la fila de abajo.
Si tienes un layout que solo queda bien a 16:9, prueba @media (aspect-ratio). Te hace casi todo el trabajo.


2
93
Plain Week: plainweek.eu
La PR, con capturas de antes y después: github.com/victor-falcon/pla…

11
Con el mismo modelo, cambiar de harness te puede multiplicar la factura por 5.
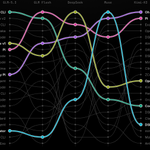
Runta ha publicado FrontierHarness Eval v1.1: 22 configuraciones de harness (Codex CLI, Claude Code, OpenCode, Pi, Cline…), 5 modelos abiertos, 62 tareas de terminal y 27.280 ejecuciones.
Lo que sale:
El harness más caro cuesta entre 1,8 y 5 veces lo que el más barato, según el modelo. Con DeepSeek, Cline CLI gastó 5 veces más que OpenCode v1 por 2 puntos más de acierto.
Pagar más no te da más aciertos. El harness que más tareas resolvía quedaba entre el 5.º y el 20.º de 22 en coste.
No hay un harness ganador. Codex CLI es el 1.º en coste con GLM-5.3 y el 16.º con Kimi-K3.
Lo que dispara el gasto es el número de pasos, no el tamaño del prompt. Y el 64,5 % del dinero se va en tareas que acaban fallando.
Los harnesses más rentables tienen tres cosas en común:
- una sola herramienta de shell hace el 61-93 % de las llamadas
- peticiones que solo añaden contexto, con un 91-94 % de aciertos de caché
- sin subagentes y casi sin resúmenes
Ojo: solo modelos abiertos servidos por Baseten. Claude, GPT y Gemini quedan para la próxima versión.
Guárdatelo para la próxima vez que cambies de modelo: prueba también a cambiar de harness, con tus propias tareas.

3
3
246
El estudio completo, con la tabla por modelo y harness: runta.com/blog/introducing-f…

14
Quería poder decirle a Claude "cada lunes a las 9, revísame las dependencias de este repo" y olvidarme del tema.
Lo primero que se te ocurre es dejar un agente en bucle esperando a que llegue el lunes. Pero cada vuelta gasta tokens, y después de muchas horas el agente va a peor.
Así que en agent-tasks quien mira el reloj es un proceso normal, sin LLM. Cada 5 minutos comprueba si toca algo. Si toca, abre una pestaña con un agente nuevo en la carpeta de la tarea. El agente hace su trabajo, deja un resumen y cierra él mismo la pestaña.
Y si algo sale mal, queda apuntado: el agente se ha muerto sin avisar, se ha pasado de tiempo, o yo tenía el runner apagado cuando le tocaba. En ese último caso también te dice por qué no se ejecutó.
El primer commit es de ayer a las 15:22. Esta mañana ya lanza tareas en otras máquinas por SSH.
Si quieres que tus agentes hagan cosas mientras tú no estás delante, guárdatelo.

1
147
Es open source (MIT). Se instala pegándole un prompt a tu agente:
github.com/victor-falcon/age…

33
Mi app de cintas de andar ya soporta una cinta que no he tenido nunca delante.
Un usuario me mandó un informe desde la app: su cinta, una PitPat, no se reconocía.
El informe traía solo la lista de servicios Bluetooth que anunciaba.
Con eso bastó para empezar:
- Busqué quién había conectado ya con ese protocolo. Dos proyectos open source lo habían usado en sus propias cintas y en uno había grabado un paseo entero.
- Con sus capturas reales monté los tests: tramas buenas, tramas rotas, mensajes partidos en trozos de 20 bytes.
- La cinta se detecta por sus servicios, nunca por el nombre, porque el mismo nombre lo usan otras variantes.
- El número de serie viaja dentro de cada mensaje de estado. No se lee, no se guarda y no sale en ningún informe.
Ya son 6 protocolos distintos, en Android y en iOS.

2
3
334
Ya puedes pedirle a Claude o a ChatGPT un gráfico de tus finanzas y que aparezca en tu dashboard de Whisper Money.
Ninguna app de finanzas trae de serie un gráfico de lo que te has gastado en el perro este año. Ni de cuántos cafés te tomas antes de las 10. Son preguntas demasiado tuyas.
Con los dashboards personalizados se lo pides a tu asistente con tus palabras. Él escribe el widget, Whisper Money lo revisa antes de guardarlo y aparece en tu dashboard con tus datos.
Si no te convence, le pides el cambio. Cada versión se guarda y puedes volver a cualquiera de las últimas 50.
Está en el plan Standard, con Claude o ChatGPT conectados por el Conector de IA.
Guárdatelo para la próxima vez que tu app no tenga el gráfico que buscas.

Vercel Labs acaba de soltar agent-desktop y es bastante útil si trabajas con agentes.
Básicamente tu IA lee el árbol de accesibilidad de cualquier app en macOS, Windows o Linux (Finder, lo que sea) sin andar con screenshots ni pixel matching. Cada elemento interactivo tiene una ref, el agente hace click o escribe, ve el resultado y repite.
Viene como CLI y librería C. La lógica del agente es tuya; esto solo le da ojos y manos al escritorio.
2
118

DeepSeek acaba de soltar su harness de agentes, que es básicamente un orquestador con arquitectura de plugins. Todo lo que hagas es un plugin, todo es componible.
Viene con Web UI, funciona en local o remoto, y está construido sobre Cordis. Está en preview así que prepárate para cambios de incompatibilidad, pero si trabajas con agentes y quieres algo flexible sin estar pegado a una plataforma, merece la pena echarle un vistazo.
1
130
