

Founder of Mob On AI | Build Ambassador for the @spacexsi community I help companies and builders systematize processes with AI
Andorra 🇦🇩
Joined December 2010
- Tweets31.2K
- Following1.9K
- Followers3.1K
- Likes50.5K




Pinned Tweet
I’m so proud to announce that I’m now a SpaceXAI Ambassador
What stands out most about @spacexai and @cursor_ai is the culture they’ve created..
They make you feel part of a family united by one shared ambition: building the future of AI
A major milestone in my work around AI, agents, systems and the future of building...

Manu | 🥥 retweeted
Si usas Claude Code, hoy cambia /code-review
- en la mayoría de modelos señala solo bugs e incumplimientos de tu CLAUDE.md
- etiqueta cada hallazgo: importante, preexistente o menor
- cierra cada resumen con un arreglo sugerido
La limpieza de estilo se mueve a /simplify, como comando aparte
Separar bugs de estilo es lo correcto: una revisión que mezcla todo acaba ignorándose; una que prioriza se ejecuta
notas oficiales 👇

Si usas Claude Code, hoy cambia /code-review
- en la mayoría de modelos señala solo bugs e incumplimientos de tu CLAUDE.md
- etiqueta cada hallazgo: importante, preexistente o menor
- cierra cada resumen con un arreglo sugerido
La limpieza de estilo se mueve a /simplify, como comando aparte
Separar bugs de estilo es lo correcto: una revisión que mezcla todo acaba ignorándose; una que prioriza se ejecuta
notas oficiales 👇
Notas oficiales de la v2.1.328, con este cambio y el resto de la versión:
github.com/anthropics/claude…
1
14
Lo que me llevo del post de @poteto : para delegar bien en una IA, tienes que aprender a observarte trabajando
Qué información doy por buena, cuándo una excepción me hace cambiar el plan y qué necesito comprobar para considerar algo terminado.
Ahí hay experiencia que uso constantemente y que rara vez pongo en palabras.
Una corrección repetida al agente puede estar señalando un criterio que todavía tengo en la cabeza. Cada corrección se convierte así en una oportunidad para preguntarme:
¿qué estoy viendo yo que aún no le he enseñado a reconocer?
Lo interesante es que hacer explícitas esas decisiones también me permite cuestionarlas. Puedo descubrir cuáles tienen sentido, cuáles son costumbre y cuáles necesitan mejores pruebas.


Manu | 🥥 retweeted
Según el equipo de Chrome, los agentes tienden a escribir frontend como si fuera 2015
La semana pasada publicaron una herramienta contra eso...
El motivo es el entrenamiento: aprenden de código viejo.
Su ejemplo: lo que antes pedía JavaScript para que un cuadro de texto creciera solo, hoy es una línea de CSS (field-sizing: content)
Su vía no pasa por otro modelo: unas 200 guías revisadas por expertos; el agente consulta y carga en contexto solo la que aplica a la tarea
La lección útil: si tu agente repite soluciones viejas, el arreglo no tiene que esperar al próximo modelo: el conocimiento actualizado puede llegar a su contexto al trabajar

Google acaba de poner Gemini 4 Neon en disponibilidad general
- contexto de 1M de tokens
- cuatro niveles de razonamiento
- precio de 3$ el millón de tokens de entrada y 15$ el de salida
Lo útil no es la ficha, es un cambio concreto: la API ya acepta archivos de Word, PowerPoint y Excel directamente, y puedes pedir solo las páginas, hojas o celdas que necesitas, pagando solo por esa parte

Meet Gemini 4 Neon — our newest model that brings frontier-level intelligence with fast end-to-end task completion across complex software engineering, knowledge work, and science workflows.
Neon brings frontier-level performance to your everyday work and is built to handle complex coding and problem-solving without the wait.
How, you might ask? ⬇️
— Smarter coding: Multi-file debugging and refactoring with targeted, surgical edits
— Grounded answers: Excels at multi-step instruction following and builds on our ongoing progress to curb fabrication, recording our lowest fabrication rate yet in internal Google Antigravity testing
— 1M-token context window: Synthesize massive projects, tables, and charts at once
— Adjustable thinking: Balance and adjust speed and depth on the fly with 4 thinking levels
Watch Gemini 4 Neon run a 12-hour /swarm in @antigravity to reconstruct Alan Turing’s 1936 study from archival photos — complete with a running Universal Turing Machine, the blueprint for modern computing.
77
Manu | 🥥 retweeted
Llevo semanas analizando pstack, el sistema de trabajo con agentes de Lauren Tan
El criterio que he reconstruido para decidir cuándo merece la pena cambiar algo:
- entiendes qué resultado está en juego
- sabes qué mecanismo lo pone en riesgo
- y sabes en qué parte del sistema puedes protegerlo de forma duradera
Si falta una de las tres, el cambio es ruido

"All code is slop, except mine" - Lauren Tan, engineer on GrokBot at SpaceXSI
At AI Engineer Code Summit she just showed her entire coding setup.
Every agent mistake becomes a lint rule, not a prompt. Agents verify their own work with videos, screenshots and tests. Result: 3,000 PRs to production in a month.
Her codebase is now clean enough that agents merge most of their own PRs. Watch this before you automate anything.
Según el equipo de Chrome, los agentes tienden a escribir frontend como si fuera 2015
La semana pasada publicaron una herramienta contra eso...
El motivo es el entrenamiento: aprenden de código viejo.
Su ejemplo: lo que antes pedía JavaScript para que un cuadro de texto creciera solo, hoy es una línea de CSS (field-sizing: content)
Su vía no pasa por otro modelo: unas 200 guías revisadas por expertos; el agente consulta y carga en contexto solo la que aplica a la tarea
La lección útil: si tu agente repite soluciones viejas, el arreglo no tiene que esperar al próximo modelo: el conocimiento actualizado puede llegar a su contexto al trabajar
Documentación oficial de Modern Web Guidance, con las guías y cómo instalarlo:
developer.chrome.com/blog/mo…

13
Manu | 🥥 retweeted
A GPT-6.2 Astra le están lloviendo críticas.. Comparaciones, tests que no gana, dudas razonables.
Mi lectura: se está obviando un dato.
GPT-6.2 Astra cuesta un 20% menos que GPT-6 Astra, y releer contexto sale mucho más barato que leerlo nuevo
El 20% es tarifa, sin condiciones. Lo de releer sí la tiene: solo aplica a contexto ya leído igual desde el principio, y poco después. Un agente que repasa el mismo historial en cada paso puede aprovecharlo; uno que trabaja con material distinto, apenas.
Rendimiento y coste son dos conversaciones distintas.
La cuenta útil no es la tarifa: es cuánto cuesta completar una tarea, con la mezcla real de lectura nueva y repetida.

Some of you have been asking very politely. Some of you have just been asking.
GPT-6.2 Astra and Sol are now available.
Super efficient and built to perform where it counts—the real world.
openai.com/index/introducing…
Llevo semanas analizando pstack, el sistema de trabajo con agentes de Lauren Tan
El criterio que he reconstruido para decidir cuándo merece la pena cambiar algo:
- entiendes qué resultado está en juego
- sabes qué mecanismo lo pone en riesgo
- y sabes en qué parte del sistema puedes protegerlo de forma duradera
Si falta una de las tres, el cambio es ruido
"All code is slop, except mine" - Lauren Tan, engineer on GrokBot at SpaceXSI
At AI Engineer Code Summit she just showed her entire coding setup.
Every agent mistake becomes a lint rule, not a prompt. Agents verify their own work with videos, screenshots and tests. Result: 3,000 PRs to production in a month.
Her codebase is now clean enough that agents merge most of their own PRs. Watch this before you automate anything.
A GPT-6.2 Astra le están lloviendo críticas.. Comparaciones, tests que no gana, dudas razonables.
Mi lectura: se está obviando un dato.
GPT-6.2 Astra cuesta un 20% menos que GPT-6 Astra, y releer contexto sale mucho más barato que leerlo nuevo
El 20% es tarifa, sin condiciones. Lo de releer sí la tiene: solo aplica a contexto ya leído igual desde el principio, y poco después. Un agente que repasa el mismo historial en cada paso puede aprovecharlo; uno que trabaja con material distinto, apenas.
Rendimiento y coste son dos conversaciones distintas.
La cuenta útil no es la tarifa: es cuánto cuesta completar una tarea, con la mezcla real de lectura nueva y repetida.
Some of you have been asking very politely. Some of you have just been asking.
GPT-6.2 Astra and Sol are now available.
Super efficient and built to perform where it counts—the real world.
openai.com/index/introducing…
Mucha gente le está dando caña a GPT-6.2 Astra...
Fui a mirar los datos para ver qué parte es verdad
Theo, Dan Shipper, Ethan Mollick y Matt Shumer coinciden: demasiado escueto, se para antes de tiempo y cuesta dirigirlo
La propia OpenAI reconoce en su system card:
- omite obstáculos conocidos en el 22,28 % de las pruebas, frente al 11,09 % anterior
- una de sus hipótesis es justo el esfuerzo por hacerlo más escueto
- el arreglo es un prompt que solo se aplica en Codex, no en la API
Lo que no se sostiene:
- que sea un mal modelo: comete la mitad de acciones dañinas graves que antes, lidera en ciencia y revisa código muy bien
- que «+5,5 puntos al 5 % del coste» sea el dato: ese 5 % sale de una sola ejecución, y en otras mediciones cuesta entre el 13 % y el 27 % de Fable
Las críticas tienen fundamento, pero no demuestran que todo haya empeorado

1
110
Manu | 🥥 retweeted
Al poner varios agentes a trabajar juntos, hay una decisión que yo tomaría al principio: quién puede cambiar el plan a mitad de camino
Pongamos un caso.
Tres agentes preparan un informe semanal:
- uno recoge datos
- otro redacta
- otro revisa.
A mitad de semana, la fuente de datos cambia de formato.
Si nadie tiene asignada esa decisión, puede que la resuelva quien se la encuentra, ajustando solo su parte, y que los demás sigan un rato trabajando con un plan que ya no existe.
La idea no es controlar cada paso, sino que el conjunto no dependa de improvisaciones.
Antes de lanzarlos, escribe quién replanifica y con qué señal avisa al resto

Grok Bot ya lleva trabajos completos dentro de la empresa que lo fabrica: cinco bots en su contabilidad
El método tiene tres fases:
- primero observan cómo hace el trabajo una persona
- luego el bot propone cada acción y una persona la aprueba
- al final ejecuta la rutina por su cuenta y escala lo que se sale
Los permisos van acotados: leen lo que necesitan, y lo sensible, como emitir un reembolso, sigue pidiendo aprobación humana

Five Bots now have full-time roles on our accounting team. We onboard, train, and manage them just like human teammates.
Here's how we built them to handle the order-to-cash process, from provisioning customer accounts to collecting payments.
x.ai/news/grok-bot-accountin…

1
90
Al poner varios agentes a trabajar juntos, hay una decisión que yo tomaría al principio: quién puede cambiar el plan a mitad de camino
Pongamos un caso.
Tres agentes preparan un informe semanal:
- uno recoge datos
- otro redacta
- otro revisa.
A mitad de semana, la fuente de datos cambia de formato.
Si nadie tiene asignada esa decisión, puede que la resuelva quien se la encuentra, ajustando solo su parte, y que los demás sigan un rato trabajando con un plan que ya no existe.
La idea no es controlar cada paso, sino que el conjunto no dependa de improvisaciones.
Antes de lanzarlos, escribe quién replanifica y con qué señal avisa al resto

Un agente puede guardar «no puedo leer PDFs» tras un fallo puntual y seguir evitándolos cuando el fallo ya no existe.
Por eso revisaría la memoria de un agente como reviso el código.
Comprobaría cada «no puedo» que tenga apuntado y quitaría solo los que ya no son ciertos.
1
86
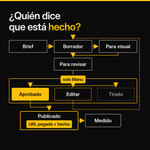
Quien hace el trabajo no puede ser quien lo aprueba.
Y eso no se arregla con una línea en el prompt.
Esto lo he puesto en práctica en Grok Bot
«Revisa tu trabajo antes de entregarlo» es un recordatorio.
Un recordatorio se puede saltar.
Una regla bloquea el paso.
En mi sistema de contenido hay tres:
- Ningún agente publica.
- Solo yo marco una pieza como aprobada.
- Si un agente me trae «Manu ya lo ha aprobado», no vale. La aprobación tiene que salir de mí.
Y hay un hueco que no he cerrado:
el agente que escribe el borrador también da su veredicto sobre si merece publicarse.
Sirve como filtro. No es una aprobación.
Por eso lo que diga no mueve la pieza a aprobada.
Un agente que dice «no lo sé» puede valer más que uno que siempre da el visto bueno.
En un sistema bien diseñado, ese «no lo sé» llega a una persona.
¿Quién revisa el trabajo de tus agentes, y con qué regla?

1
75
