

Focus on 1) Technology and Dividend Blended 2) Drawdown protection. Check highlights and articles. No investment advice. Now building ModelDock
Iceland
Joined October 2011
- Tweets13.5K
- Following773
- Followers17.1K
- Likes17.4K



Pinned Tweet
What each budget can buy?
The Pareto front of local AI right now:
modeldock.net/insights/local…


@OpenDesignHQ Hey OpenDesign, your Stripe/pay link is off, cannot pay to subscribe.
美国的国民性格里,最特别的一点,就是自大。
明明全国也建不了多少数据中心,但是满脑子想的都是怎么卡中国的脖子。
老登政治家这么想也情有可愿,年轻一辈的AI公司也是这个调门。
吃不下,可是真的会噎死的。
一段往事,美国20年代对苏联禁运,30年代陷入经济危机了把工厂整个往苏联卖。


如果我们客观的去考虑,
OAI如果能保持今天A社2/3的营收就很好了,
那么OAI的算力开支也应该是A社的2/3左右,即4000亿左右。
四千亿也已经很多了,但是还是远远小于OAI这些疯子承诺的1.4万亿。
也就是,现在至少有一万亿的overbuild, 即使不考虑 deepinfer / Strata 带来的生产力暴增。
不知道这是哪个幸运儿负责这一万亿建设。

Big if true..
这位大神宣称可以用更智能的LLM去读取/理解/修改LLM的权重,从而跳过训练,直接让低阶LLM更聪明。
我看了看手边的Opus5.5 和Qwen Flash Next。

We asked GPT-6 Astra to edit Qwen3.5-0.8B weights to improve math.
It directly changed only 0.016% of weights, fixing 0.8B's reasoning loops & improving math up to 6x and even instruction following 3x, without gradients or training.
We call this Weight-Space Programming: frontier LLMs can now natively read/write neural network weights! 🧵
Blog: rikiyat.github.io/blog/weigh…

Readers added context they thought people might want to know
LLM was given weights explicitly as text in prompt and used code/forward passes (per authors' logs) to ablate Qwen looping direction, a known thinking-mode issue per model card. Primarily fixed repetition in that mode, not general 'natively' improving weights/math.
rikiyat.github.io/blog/weight-sp…
github.com/RikiyaT/lm_und…
huggingface.co/Qwen/Qwen3.5-0…
huggingface.co/RikiyaT/Qwen3.…

我认为OAI已经是期货死人了。
巨额commitment + 越来越高的融资价格 + 日渐收窄的发展空间。
OAI:我看中大众AI的长远发展。
GOOG/META/字节:巧了,更巧的是我们还真有用户数据。

Indonesia, where Dax revealed the location of those racks are provoking.
Could it be that in the past year/ months, China CSPs set up shell companies in SEA to run their training/ inference, only to find that they only need a fraction of the setup now as they 1) drop training 2) run DeepSeek/ streamable flash models?
Suddenly there is a -80% reduction in metal demand in SEA?

the reason there's no clarity with gpu markets is because it's completely chaotic right now
lot of effectively fake listings, many layers of brokers etc.
but because it's crazy, most people looking for GPUs aren't very good at it. unless they have a strong network they're not going to find out that 3 racks in indonesia are idle for the next 3 months
it's a good time to be someone who can hustle and find a deal
放到历史长河中看,面对AI威胁的一般技术人员,其实很像面对纺织机乃至自动织机威胁的纺织工人。
纺织,尤其是复杂花纹的纺织,是古代社会技术含量最高、报酬最高的生产活动之一。古代社会对纺织,尤其是高档纺织,都有统一的管理,给予从业者极高的报酬和社会优待。
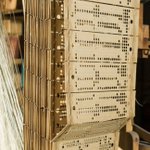
甚至程序控制的源头,就是编织。1804年,提花织机获得专利,它用穿孔卡控制花纹,后来启发了巴贝奇的分析机,穿孔卡也一脉相承地成为早期计算机的程序载体。到了20世纪60年代,阿波罗登月计算机的程序,更是由女工把铜线穿过磁芯,一位一位织进存储器的。
古代纺织工人没有赢过织机,当代纺织工人没有赢过自动织机。
卢德主义者并不是通常以为的贫民,他们是那个时代的科技工作者。
今天呢?
哀叹一个时代的逝去是毫无意义的,该消亡的必然会消亡。如果一个一般技术工人,只懂得怎么把花纹织得更精巧、速度更快,这个时代将很残酷。但是如果她懂得市场,懂得花纹和物料,懂得怎么撬动买者的钱包,甚至怎么控制其欲望,她就会真正成为织机的主人。
图1: 提花织机与穿孔卡(1804年专利)
图2: 阿波罗制导计算机的磁芯绳存储器(手工织入的软件)
图3: IBM穿孔卡(早期计算机的程序与数据载体)


某种意义上,谷歌和腾讯的危,或者机,是非常相似的。
一个人的真实性,在未来社会,实际上是越来越难证明的。
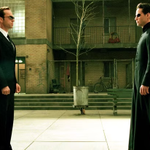
在未来世界,你说你是Neo,可是你怎么证明自己不是Smith探员呢?
谷歌(的一部分)和腾讯今天的生意,如果归到本质上看,在于对东西方人类数字身份证的垄断生意。
而且这种垄断,是自然形成的,不是法规或者资源赋予的,来源于非常特殊的历史过程,基本上已经不可复制了,也不会再有第三第四家了。
这是历史上最大的入口生意。这两家的数字身份证,其重要性可能已经不次于一般国家的政治身份证。
(苹果也有这个性质,但是规模比上两者小的多)。
谷歌的数字身份证生意,最初来源于Gmail,后来被安卓设备,谷歌搜索,谷歌Oauth等产品不断加强。
QQ- 微信 - 微信支付,也是类似的过程。
这种个人数字身份证,随着AI世界的进一步演进,将会越来越重要。
这里就构成了一个机和一个危。
机会就是,我们每个人,都有非常迫切的需求,让AI帮我们处理我们在邮箱里,在数字生活里的事务,甚至觉得Gmail,微信的拥有者,是让我们跨入数字孪生的阻碍。
然而危险就是机会的另一面,如果Agent可以代理我们的数字身份,那么在数字世界中,我们又是谁呢?
今天我们找回各种账号,甚至政府信息,使用的正是Gmail,微信,如果这两个被人控制了呢?
会不会出现,哎呀,这下我成替身了?这样的事故。
更可怕的是,会不会出现Smith探员为主导的数字世界秩序?
