

「お前もエージェントビルダーにならないか?」AIエージェントの専門会社、株式会社ジェネラティブエージェンツ(Generative Agents, Inc.)代表 ■AIエージェント開発の解説書を多数書いてます ■2021年に富士山🗻の麓に移住 ■妻と4人の子どもとイヌとGPUと共に生きています ■DMはお気軽に📨
Yamanashi
Joined May 2007
- Tweets18.6K
- Following1.2K
- Followers6.2K
- Likes23K



Pinned Tweet
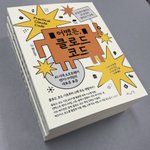
【Claude Codeの解説書、12/26発売!】
吉田さん @yoshidashingo 大嶋さん @oshima_123 と共に、コーディングエージェントの一つであるClaude Codeの解説書を書きました!
12/26が発売日なので、冬休みのお供にお買い求めいただけると嬉しいです。
本書は2部構成で、前半はClaude Codeをゼロから利用できるようになるためのハンズオン中心、後半はAIエージェントとしてClaude Codeの動きを理解し、指示追従させるための問題切り分け方法や、具体的にスラッシュコマンドやスキルをどのように設計すれば良いかを扱っています。
これから始めてClaude Codeを触ろうとしている人でも、本書を読むだけでチームのためにスキルやスラッシュコマンドを整備できるところまで到達できるようにデザインしています。
ところで・・・そもそもClaude Codeのように、アップデートの激しいプロダクトの解説を書籍化する意味はあるのか?と疑問に思われる方もいらっしゃると思います。
疑問はもっともで、プロダクトの機能解説だけをパッケージしたとしても、すぐに陳腐化する内容にしかならないと思います。
その意味で、本書は、
「これから当たり前になる『AIエージェントとの協働』という文脈の中で、Claude Codeというコーディングエージェントを題材に、AIエージェントの動作原理や操り方を理解し、今この瞬間から協働に向けた一歩を踏み出せる」
ということを意識して執筆しました。
なので、副題に
『現場で活用するためのAIコーディングの思考法』
と、思考法というキーワードを入れています。
スキルやスラッシュコマンドという機能そのものの理解は、今この瞬間であれば大いに役に立ちますが、おそらく100%陳腐化する知識です。
しかし「なぜこのような機能がClaude Codeに存在しているのか?」という文脈ごと理解していれば、今後どのようなコーディングエージェントが出てきたとしても、どのような新機能が出てきたとしても、知識を糧に前進することができます。
あまりにも高速にアップデートの進むAI活用において、まず基礎を理解してからゆっくり実務に活かしていく、という時間は、実務者にこそないはずです。
だからこそ、実務で即座に活かしながら、理論も同時に学ぶことができる構成を重視したのでした。
本書があなたのClaude Code自体の使いこなしだけでなく、『どんなアップデートが来ても怖くない状態』になるまでをサポートできることを願っています!
---
宣伝ポストで恐縮ですが、共感頂けた方はリポスト頂けると大変ありがたいです!
よろしくお願いしますー!
👇Amazonリンクはコメントにて。

Atlas Cloud、Novita、SteamLakeがMiniMaxの推論を自社で実施せず、MiniMaxに転送していたというOpenRouterのインシデントが発生しています。
プロバイダによる推論の転送を許すと言うことは、OpenRouterにおけるプロバイダ毎のNo Trainなどの表示の意味が全くないということになり、推論ルーティングサービスの信頼性の根幹を揺るがす事態だと思います。
雑誌連載でもOpenRouterを紹介した責任があるため、現在OpenRouterに対し書面でこのようなことが許されるのか、質問票を送っています。一次回答としては、あとから人間のサポートチームが正式に回答を送るとのことだったため、回答があり次第共有します。

the OpenRouter situation for anyone curious:
-someone managed to access outputs sent to MiniMax
-researcher discovered this by sending a secret links
-40 to 130 hours later someone opened the secret links
-oop, this means that someone accessed your outputs!!
-AltasCloud/Novita/StreamLake were forwarding requests to MiniMax???? what the helly?
ugh.

最初からアセスメント作ってもらって、その結果をベースに組み立ててもらう方が効率的な気がするんだけどなー。最初のアセスメントが死ぬほど苦痛だけど。

外网最近很火的一个学习方法:MIT 学霸用 AI,在48小时内快速吃透一门陌生学科。
第一步不是直接问 ChatGPT“给我总结一下”,而是先建立一个足够可靠的 AI 知识库。
他上传了6本该领域的经典教科书、15篇研究论文,以及这门学科的全部课堂讲义。
这样 AI 的回答就不再只是网上东拼西凑,而是基于指定资料帮他梳理知识。
资料准备好以后,他只问 AI 三个问题。
1⃣第一个问题:这个领域有哪些被普遍接受的核心共识?请整理出它的底层概念、关键原则和整体框架,并解释这些知识之间的关系。
这个问题的作用不是总结材料,而是先画出整门学科的知识地图。你需要先知道哪些是地基、哪些是分支,再决定时间应该花在哪里。
2⃣第二个问题:这个领域目前存在哪三个根本性争议?请分别说明各方的观点、依据和反对理由。
一个领域真正有价值的地方,往往不是大家都背得出来的结论,而是专家还在争论什么。看懂这些分歧,才能理解不同理论的边界、证据和隐藏假设,不会把课本上的每句话都当成绝对真理。
3⃣第三个问题:根据这些资料生成10道测试题,覆盖核心概念、因果关系、实际应用和主要争议,先不要提供答案。
接下来关掉资料,自己回答。答完以后再把答案交给 AI,让它逐题批改,并继续追问:
“我的回答遗漏了哪些关键点?哪些地方只是记住了结论,却没有真正理解?”
这套方法的精髓,不是让 AI 替你读书,而是让它帮你完成三件事:通过领域共识建立知识骨架,通过领域分歧看清理论边界,再通过测试题暴露自己的认知漏洞。
很多人所谓的 AI 学习,只是把“自己看总结”变成了“让 AI 生成总结”,大脑依然没有参与加工。
这套方法反过来利用 AI 增加学习难度:逼你比较、判断、回忆、输出,再接受纠错。虽然过程更痛苦,却更接近真正有效的学习。
当然,48小时不可能让人真正精通数学、物理这类需要长期训练的学科。
但它确实能让你快速搭起知识框架,找到最重要的问题,避免在陌生领域里漫无目的地看资料。AI负责整理地图,你负责真正走一遍。
ocw.mit.edu/

2
693
こう考えると、AI駆動開発の本質は、ソフトウェアファクトリー的に次々にソフトウェアを作り出すというよりは、メンテナンスを中心に据えた、CI/CDを含めたループ構造をいかにAI駆動で実現するかということにある。

これは素晴らしいのでは!

Say hello to Relate: an open source, embedded graph database that helps your agents build and understand relationships in any data.
⏱️ Query in seconds: Relate has no server installation step and no account setup.
🧠 Memory with structure: Relate lets your agent store what it learns as connected context. Combine vector similarity search and graph traversals in a single Cypher statement.
We are super excited about this launch! Built on 20 years of #Neo4j expertise, Relate gives AI agents lightning-fast structured memory with full Cypher and GQL compatibility, unified vector search, and native agent integration, and scales effortlessly to Neo4j Aura whenever your project grows.
Take a look at the demo and how to get started here: bit.ly/3WvAWqI
#relate #relatedb #AgenticAI
@steveonjava @shasbe

ALT Relate by Neo4j
2
560
Masahiro Nishimi | Generative Agents retweeted

Say hello to Relate: an open source, embedded graph database that helps your agents build and understand relationships in any data.
⏱️ Query in seconds: Relate has no server installation step and no account setup.
🧠 Memory with structure: Relate lets your agent store what it learns as connected context. Combine vector similarity search and graph traversals in a single Cypher statement.
We are super excited about this launch! Built on 20 years of #Neo4j expertise, Relate gives AI agents lightning-fast structured memory with full Cypher and GQL compatibility, unified vector search, and native agent integration, and scales effortlessly to Neo4j Aura whenever your project grows.
Take a look at the demo and how to get started here: bit.ly/3WvAWqI
#relate #relatedb #AgenticAI
@steveonjava @shasbe
ALT Relate by Neo4j
素晴らしいー!

#Elith (@elith_pr) と #NVIDIA (@nvidia) は、オープンソースペルソナデータセット Nemotron-Personas-Japan の金融ドメイン拡張版である Nemotron-Personas-Finance-Japan を公開しました。
huggingface.co/blog/nvidia/n…
日本の人口動態に合わせた属性で100万人分のペルソナ (計900万件) が入っています。
合成データを作成する際に多様性をもたせるシードとして利用したり、これを元にマルチエージェントのシミュレーションを行う、学習データに利用するなど様々なユースケースを想定しています。
Elith では、マーケティング用のシミュレーションプロダクトや、合成データ作成のコンサルティングも行います。


問いを持つことが大事と言われるけど、問いを持とうとしても大した問いが出ることはないとも感じており、果たして問いとはどこから出てくるのか、問いの源泉が大事だと大事だと思っている。そして最近感じているのは、それはその人の美学なのではないかと。美学が魅力をつくり、良い問いを生み出す。
8
700

iPad miniに電話(とか、Apple Payとか)がつけば個人的には解決なんですよねー。
itsoku.org/archives/63591668…

最高に気になるー!

12月19日(土)・20日(日)の2日間にわたり、東京(国立情報学研究所)にてワークショップ「形式検証の最前線」を開催いたします! 形式検証に関連する最先端のトークが目白押しです。ぜひ参加をご検討ください!
ホームページ:
group-mmm.org/~kazuki/FFV/in…
2
595