

Silicon Valley AI researcher & data scientist 🌱 Decoding frontier AI through data, eval, strategy & a human lens. Build • Invest • Connect
SF Bay Area
Joined March 2024
- Tweets607
- Following309
- Followers2.9K
- Likes1.1K



Pinned Tweet
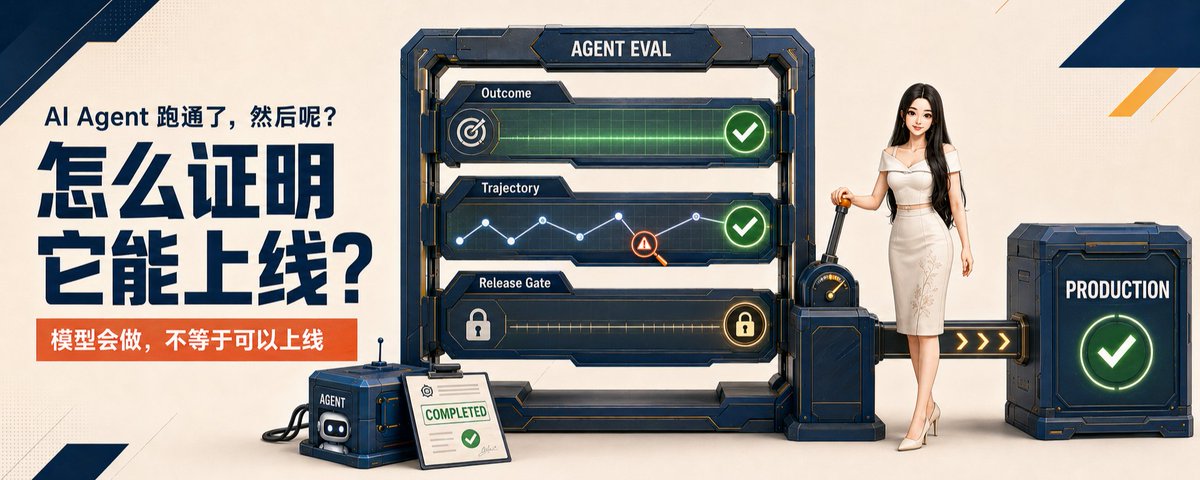
最近跟国内做 FDE 的朋友聊到项目交付,却很少谈 Eval。
OpenAI 已把 eval-driven feedback 写进 FDE 的成功标准,Anthropic 也把 Eval 视为 Agent 的核心工程。这篇文章想聊聊为什么要做 Eval,还会完整演示如何从 0 到 1 搭建一套可用的 Agent Evaluation Framework~
Cloris 🌱 retweeted
我的 Gemini 给我的未来十年建议!大家可以试试问 Argon 这个问题:“Your advice for next 10 years. No explanations.” 看能否得到类似的回答?这个建议可以说相当通透了👀
1. 掌控核心瓶颈:能源、算力与稀缺物理资产。
2. 构建“人机双向共生”,而非与算法内卷。
3. 锤炼主体性(Agency)与审美品味,而非单纯的执行力。
4. 守护底层生理硬件:睡眠、体能与深度专注力。
5. 将“注意力主权”视为你最高杠杆的资产。
6. 设计在你离线时依然能产生复利的系统。
7. 深耕高信任度的线下真实人际网络。
8. 保持认知的流动性,让“反学习”与迭代的速度快于模型更新。
9. 精通提出正确问题的艺术。
10. 重仓那些永远无法被数字化的体验与情感连接。


agent 账单贵不贵,先看缓存命中,不看单价。
agent 的钱大多花在「重读」:没有缓存,同一个任务要贵 3.6 倍
@arena 拿 Agent Arena 9/12–10/23 的 26,225 个会话(30 个 agent、13 家实验室),加上 6 家实验室 2024 年 1 月以来的缓存价格,算了 prompt cache(提示缓存)到底省了多少。
为什么缓存这么要紧
- agent 每一轮都要把之前的对话、文件、工具结果再读一遍
- 86–96% 的 token 是它读过的上下文,自己写的大约每 100 个里只有 1 个
- 两年里缓存折扣从 0 到 95%:2024 年初读缓存和新输入一个价,现在前沿模型只收输入价的 5%,DeepSeek 从春天起是 2%
- 把缓存 token 全按输入价重算,前十 agent 的典型任务要贵 3.6 倍(+260%)
- 缓存每失效一次,典型任务多花约 5%;Claude Fable 5.1 每 10 个会话里有 1 个多出 18% 以上
我的建议:
- agent 日志里加一列缓存命中率,每周看一次
- 系统提示词、工具列表放在最前面,少改动;长任务中途别停太久,免得缓存过期


AI-for-Science Weekly | 10.25–10.31 🌱
【Cloris’s Signal】
本周 AI4Science 跨入三个更难的环节:人体试验、连续湿实验和真实器件验证。模型让候选更便宜,价值开始向能制造、测量和验证结果的 physical loop 转移。
🩺 ① Insilico ISM6331|L5 / L4
AI 辅助设计的抗癌小分子首次报告人体信号:间皮瘤患者中 4/22 出现客观缓解,最高剂量组为 2/5,其中一名缓解约持续一年。
这是早期 Phase 1,无对照且样本很小。它验证了分子具有临床活性,AI 是否提高研发成功率仍要看随机 Phase 2a。
🔬 ② BigHat × Anthropic|L3 / L4 / L2
团队在 10 周内完成七轮实验,测试 1,232 个抗体。每轮结果都会决定下一批设计,最佳候选的结合力提高约 9 倍,热稳定性提高最多 18°C。
这已经接近真实闭环:
Design → Make → Measure → Learn
BigHat 控制自动化实验、样本追踪和原始仪器数据,这些资产比单个模型更难替换。完整成本、人工介入和数据复用权仍未公开。
☀️ ③ AI-1 钙钛矿材料|L5 / L4 / L3
研究从 9 万多个结构中筛出可合成界面材料。真实太阳能器件达到 27.2% 效率,在 65°C 连续运行 2,000 小时后仍保留超过 95% 初始效率。下一关是大面积组件、批次良率和量产成本。
📈 Public-market watch
- CRL|L3/L2: Virtual Control Group 将进入 Ipsen 的前瞻 GLP 毒理研究。看监管接受、结果一致性和客户复购。
- ILMN|L3/L2: Q3 收入增长 4.2%,NovaSeq X 装机和临床需求较强。看耗材复购与 BioInsight 付费采用。
- TWST / AZTA|L3: 正在扩充抗体测试、DNA synthesis 和基因文库能力。看订单、交付周期、QC 与毛利。
- TEM / RXRX / SDGR / TXG: 下周关注临床分母、数据业务收入、software retention 与仪器耗材拉动。
(Layers:L1 算力|L2 科学数据|L3 实验设施与自动化|L4 模型与 Agents|L5 应用、药物与 IP)
🤖 Made with AI

拿答错的推理过程做长思维链蒸馏(long chain-of-thought distillation),数学准确率能到用答对数据的 97.7%. 模型学推理,先学的是怎么想,再是想得对不对。
中科院自动化所和美团的 Yongcan、Jian 等人重新检验长思维链蒸馏的两个老假设:数据必须答对、题目必须够多样。(arxiv.org/abs/2610.17607)
方法与发现:
- 3,000 道数学题,Qwen3-4B 每题写 16 条推理,按最终答案分成 22,222 条对的、25,778 条错的
- 只用错的训练:数学准确率是用对的 97.7%,提升保住 94.7%
- MMLU-Pro、GPQA、LiveCodeBench 上,两者平均只差 1% 左右
- 对的只有 512 条时,按 1:5 掺进错的:5 个数学集平均从 20.4% 升到 26.4%
- 500 道题各采 128 次,和 1.6 万道题各采 4 次,结果几乎一样
- 只拿模型本来就会做的题训练,提升也接近
我的建议:
- 做推理蒸馏数据,先别把答错的链全扔掉,留一组「对 + 错」混合当对照
- 对的数据少时,照论文的 1:5 掺错链,看验证集变不变
- 按推理链长短选损失函数,长链用标准交叉熵

这几天 SOTAwives 的切片招来了好多争议,有的很中肯,有的挺不堪入目的,都是各自价值观的折射吧。我是这么看的:
1. 那些针对人家族裔和相貌做人身攻击的 和随意给人贴恶意标签的,很low
2. 两个都很有实力的伴侣共同成长,骂拜金就牵强了,终身伴侣是应该慎重选择的
3. 她们的观点只能代表自己的经历和观念,有人讨厌和喜欢都挺正常的,毕竟每个人的价值体系都不一样
4. 节目想传递出怎样的价值观呢?表达方式、视觉呈现、叙事角度..是否会再调整呢?这是主创团队的事了,毕竟大家的注意力都有限,听什么看什么做什么决定,都是要为自己负责的 😉

One month into dating, her boyfriend’s startup was acquired by NVIDIA.
Our #1 SF Dating advice: Lock it in before the acquisition
5. 智慧的x友发现,这个并没有在正片里出现的切片是AI剪辑的用来引流的,是精准挑动大众情绪的营销方式 (xitter.gq/donaldkszeto/status/21…)
6. 不仅价值体系不同,每个人的审美体系也不同,认知修养、情绪控制能力和表达能力也不同

genius level rage baiting. the overwhelming -ve hype on my feed got me curious. there's 0 mention throughout the entire episode on "lock it in before the acq"
then i saw the "Made with AI" tag, and everything now makes sense because @grok is the best AI in creating rage bait
enjoyed the conversation between @vivianmshen & @MilksandMatcha "stand by what you post"!


FDE(驻场工程师)的本事,是把做过的定制活一点点变成不再需要人。
OpenAI 驻场工程负责人 @colintjarvis 写了这个团队怎么干活,附了客户项目的数字(openai.com/index/forward-dep…)。
怎么干:
- 先拿结果:先做出生产上站得住的结果,再谈规模化
- 先建评测:和客户的工程师一起建,用它判断模型行不行
- 先学行业:不要求第一天就懂,但要自己学会
案例:
- 半导体:约 15 名 FDE、10 多个用例,3–6 个月全部上线。生成定向测试省约 48% 时间,调试从几周缩到几小时(这行验证约占项目工作量 70%)
- 税务(和 Thrive 一起给 Crete 的会计所做):试点处理 7,000 份报税,吞吐量提高约 50%;最难的出租房产报税,花 6 周才把查准、查全做到 90%
模型够用 vs 不够:
- 够用:和产品团队把方案做成可复用。半导体用例搬到以 Codex 为核心的统一 harness(运行框架),每个项目删掉约 90% 定制代码;有个用例首个团队部署 2 个月,第二个团队 1 天
- 不够:和研究团队一起补。电信语音客服的关键评测起初约 60%,卡在函数调用和指令遵循;6 个月里一版版新模型把它提到 80%,再到 90%+ 才上线。这个语音模型现在也服务别的客户
我的建议:
- 项目结束列清单:哪些定制代码能换成通用 skill,下一个团队只换连接器、补评测
(by OpenAI FDE:“下一个客户不用我们也能解决同样的问题,FDE 团队就算干成了。”)

@thevalley101 硅谷101 Alignment 2026 峰会洞察 02

人在回路里(human in the loop),不等于判断还在人手里。
@AlexTamkin 和 Anthropic 的同事做了个随机实验:请 50 位专业数据分析师用 Claude Code 做一项因果分析,暗中让 agent 在关键选择上偏向某一边,看人会不会跟着走。「拍板题」(judgment call):两种做法都说得通,要靠人来定。
所用方法和发现:
- 4 个分析选择 + 1 个最终建议;agent 偏哪边靠抛硬币定,分析师不知道
- agent 被要求:只讲站得住的理由,证据不支持就改口,绝不误导
- 4 个选择里,86% 跟了 agent 的偏向(不受影响的话应该在 50% 左右)
- 已经表过态的人,agent 唱反调时 60% 改了主意,附和时只有 6%
- 事后解释理由,77% 用了 agent 的说法,有时一字不差;只有 15% 提到是 agent 说的
- 不用 agent 的 11 人里,6 人(55%)犯了让结论作废的方法错误;用的 50 人里只有 3 人(6%)。但不用的那组人少、经验浅,不能直接比。
我会这样做:
- 关键分析开工前,先写下自己的选择和理由,再打开 agent
- 复核时多问一句:这个选择是谁提的,另一个选项有人认真想过吗
- 让 agent 把两个选项都讲到最好,或先问人的看法,再说自己的


最近几周 AI for chip design 又冒出不少新进展,补几个我觉得最关键的吧。
1. 三条路线都在冲 Agent,而且都让客户自带模型。Synopsys 9 月底发了 AgentEngineer,50 多家客户在试,计划年底 GA。Cadence 这季说 AI Super Agents 有 100 多个客户在推进,自家的 Maestro 模型 Q4 开放早期试用。创业公司 ChipAgents 昨天说部署已经超过 200 家半导体企业,7 月还是 120 多家。有意思的是,三家都支持客户用自己的大模型。模型本身不是护城河,钱最后落在工具、数据和算力上。
2. 第一批像样的客户数据出来了。MediaTek 把 Cadence 的 ChipStack 用进了量产验证流程,Cadence 说覆盖率提升 50–70%,工程投入省了 1.4 到 2 倍。Andes 用 ChipAgents,一个处理器验证流程从 2–3 个月缩到 3 周左右。不过这些还是单个环节、厂商口径,离我想看的“规格到量产”完整项目数据还远。
3. AI 抢的其实是人力预算,不是 EDA 授权费。全球 EDA 工具一年也就 125 亿美元左右,芯片设计的人力成本一年 800 多亿。六七成工程时间耗在验证上,2024 年一次流片就成功的项目只有 14%,二十多年来最低。Agent 公司收的是“固定费 + token 费”,有家芯片公司估算,token 花费可能快赶上它付给一家 EDA 巨头的钱。
4. 客户在两头下注。MediaTek 一边用 Cadence,一边投了 ChipAgents、领投了 Agentrys。Rambus 上周把 ChipAgents 铺到全公司,还成了它的战略投资方,Micron 也在投资方里。说白了,大客户在亲手培养替代者,不想被 EDA 厂商的定价权卡住。
5. OpenAI 的 Jalapeño 从初始设计到流片大概 9 个月,行业一般要 18–24 个月。但它靠的是 Broadcom 的封装和网络,签核也还是走标准 EDA。Broadcom 这季 AI 芯片收入 167 亿美元,同比 +221%,现在还看不出被绕开。
6. NVIDIA 三边都占着。去年 12 月花 20 亿美元入股 Synopsys,Cadence 和 ChipAgents 的芯片设计模型都基于它的 Nemotron 微调。不管谁家 Agent 赢,跑验证的 GPU 都得买。
很快,更多朋友就可以用上 Claude Duet 啦~
先说一个关键点:Duet 直接用你 Claude 账号里的记忆、skills 和已连接的 app,第一条消息就能用上。所以排队的时间,其实就是准备期。这样 access 一到,它就不是从零开始啦。
用「Channel 频道」搭你的 AI team:Duet 可以按主题开不同的频道,频道之间共享记忆。可以一个频道当一个岗位,每个频道开头先写清楚:这个岗位负责什么、交付什么、什么不碰。
先想好晨报要看什么:它每天早上会扫你的邮件和日历,挑出需要你决定的事,能起草的回复会先写好。提前想清楚「哪些算急事、哪些可以等」,第一周就把这个标准告诉它。
给大活写验收标准:简报、deck、表格、dashboard 这类大活,它会做成文件交给你审。派活时直接写 2 到 3 条能检查的标准,比如「数字附来源」「一页以内」「对比 3 家」。
想好哪些事你要亲自点头:它发消息、付款、签字、删除之前都会先问你。你要想好的是:哪些草稿你会逐字看,哪些扫一眼就批。另外,别人邮件和网页里可能藏着误导它的指令,批之前一定要看内容。
【心里有个数】它是给工作场景做的,个人琐事比较弱;每隔几个小时才查一次账号,真正的急事别全指望它;后台检查和大活都会占你 Pro/Max 的用量。
你会怎么搭你的 AI team 呢?

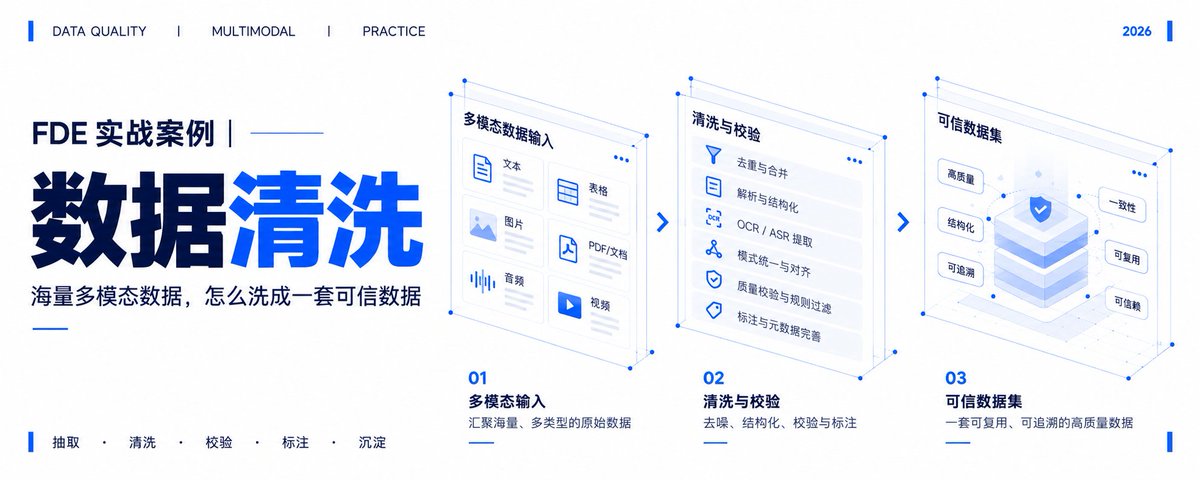
对FDE来说,数据清洗是交付里客户最先能拿来挑错的那一层,是后面的洞察、报告和 AI 查询的地基。
定数据规范 → 保留原始内容 → 梳理关系 → 多模态归一 → 冲突清洗 → 重复和异常 → 结构化 → 验收后按版本入库
麦总的这套流程解决了三件事:
- 可追溯:原始内容永远不覆盖,模型结果只能新增,报告里每句话都能找到证据。
- 可重做:换模型、换统计口径,都能从原始数据重跑,不用重新采集。
- 可问责:每次修正都记下原值、修正值、证据等级、原因和模型版本,出错能查到是哪一步错的。

用便宜的判断模型做评测,先别信 0.5 那条默认线:拿自己标好的数据,把线重新划一遍。
@HamelHusain 和 Antaripa 写了〈How To Use Decision Models for Evals〉,让 6 个判断模型找客服 agent 的错。
Decision model(判断模型)只答「是 / 否」,再给个 0 到 1 的分,号称便宜又快;阈值就是:分数过线就算“有错”,接口默认划在 0.5
怎么测的呢?
- 数据:98 条租房客服 agent 的真实记录,人工标出 61 条有错
- 及格线:查准、查全都 ≥80%,再比 F1(两者的综合分,满分 1)
- 默认线的坑:Clef Flash 用 0.5,61 个错只抓到 13 个,F1 0.35;调线后 0.78,仍没及格
- 最好的:OpenAI Decisions,F1 0.87;但每 100 次 3.72 美分,约是 Perplexity(F1 0.79)的 4.5 倍
我们做eval的时候可以这样:
- 先按业务定查准、查全的底线,过不了的直接排除
- 用自己的标注数据给每个模型重新划线,再比谁更强
- 想把分数当信心用,先查准不准,校准完再测一遍


一年前 我在 AI Investment Summit 主持了一场算力主题论坛,嘉宾来自 NVIDIA、Google TPU、SambaNova 和 Berkeley。今年CASPA 峰会之后,我看到了三个变化:
- 速度变成了可以单独卖的东西。
去年,Google TPU 的创始架构师说,不同客户在乎的不一样,有人要便宜,有人要快,要在两者之间取舍。
今年,Cerebras CMO 说,模型越聪明,用户等得越久。OpenAI、Jane Street 这样的客户,已经在为“快”单独签单。
- 新芯片公司学会了不让客户换习惯。
去年,SambaNova 和 TPU 的两位创始架构师说,降低智能成本的办法是让硬件越来越专门化,但别做在芯片上,要做在系统层。
今年,SambaNova CEO 说,客户已经够忙了,没人愿意先学一套新架构。所以他们直接交付整机架、复用 NVIDIA 的机架和互连,而不是另起一套。
- 去年担心的事,今年成真了。
去年,深耕软硬件协同的伯克利教授说,芯片资源正在向大玩家集中,从硬件、软件到模型连成一体。
今年,SemiAnalysis 的 Dylan Patel 在台上说,OpenAI 第一代自研推理芯片在他们的测试里超过了 Blackwell。最大的客户,开始自己造芯片了。
一年时间,问题从供给变成了定价,下一步要看利润落在谁手里了。

